第八讲 总体、样本与抽样分布
核心概念梳理
辅助知识点
在学习统计推断前,我们必须清晰地辨别三个名字相似但意义迥异的概念。这三者的关系是整个统计推断的基石。
总体分布 (Population Distribution)
- 是什么? 指的是我们所研究的全体对象中,某个变量的真实分布情况。例如,中国所有劳动力的真实收入分布。
- 特点: 这是我们最想知道的,但通常是未知且不可得的。因为我们几乎不可能去测量每一个个体。它的参数(如总体均值 μ、总体标准差 σ)是固定但未知的常数。
样本分布 (Sample Distribution)
- 是什么? 指的是我们从总体中抽取出来的那一小部分数据中,某个变量的分布情况。例如,CLDS调查中几千名受访者的收入分布。
- 特点: 这是我们实际拥有的、看得见摸得着的数据。我们通过分析样本分布,来推断总体分布的样貌。它的统计量(如样本均值 X̄、样本标准差 s)是已知的,但每次抽样都可能不同。
抽样分布 (Sampling Distribution)
- 是什么? 这是一个理论上的、抽象的分布。想象我们从同一个总体中,反复抽取无数个大小相同(例如,n=200)的样本。每一个样本都会有一个自己的均值。把这无数个样本均值收集起来,它们自身就会形成一个分布,这个分布就叫做“均值的抽样分布”。
- 特点: 这是连接样本与总体的桥梁。中央极限定理告诉我们,这个分布近似于正态分布。它的标准差有一个特殊的名字,叫做标准误 (Standard Error)。我们正是利用抽样分布的这个性质,来判断我们的样本结果在多大程度上是可靠的,并据此构建置信区间。
第十一讲 相关分析与简单线性回归
0. 预处理
- 设置工作目录
| |
- 导入2016年中国劳动力动态调查数据 (CLDS)
| |
- 数据准备:在本讲中,我们将探究“教育年限”与“个人总收入”之间的关系。
- 为满足后续分析的要求(特别是回归分析的正态性假设),我们将对收入变量进行对数转换。
- 我们将学历变量转换为连续的教育年限变量。
| |
第十二讲 多元回归分析
导论:从简单回归到多元回归
辅助知识点: 在上一讲中,我们学习了简单线性回归,即用一个自变量来解释和预测因变量。然而,现实世界中的社会现象远比这复杂,一个结果往往是多个因素共同作用的结果。例如,个人收入不仅与教育水平有关,还可能受到年龄(经验)、性别、行业等多种因素的影响。
多元回归分析 (Multiple Regression Analysis) 正是处理这种多因素影响的强大工具。它允许我们在一个模型中同时放入多个自变量,从而实现两个核心目标:
- 更准确的预测:通过综合考虑多个相关因素,模型对因变量的预测能力通常会比简单回归更强。
- 更纯粹的解释:多元回归能够估算出每个自变量在 “控制”了其他自变量影响之后,对因变量的 “净效应” (net effect)。这是社会科学研究中探寻因果关系、排除混淆变量的关键一步。
0. 预处理
- 设置工作目录
| |
- 导入2016年中国劳动力动态调查数据
| |
成立一个追踪新冠病毒健康状况的国际联盟
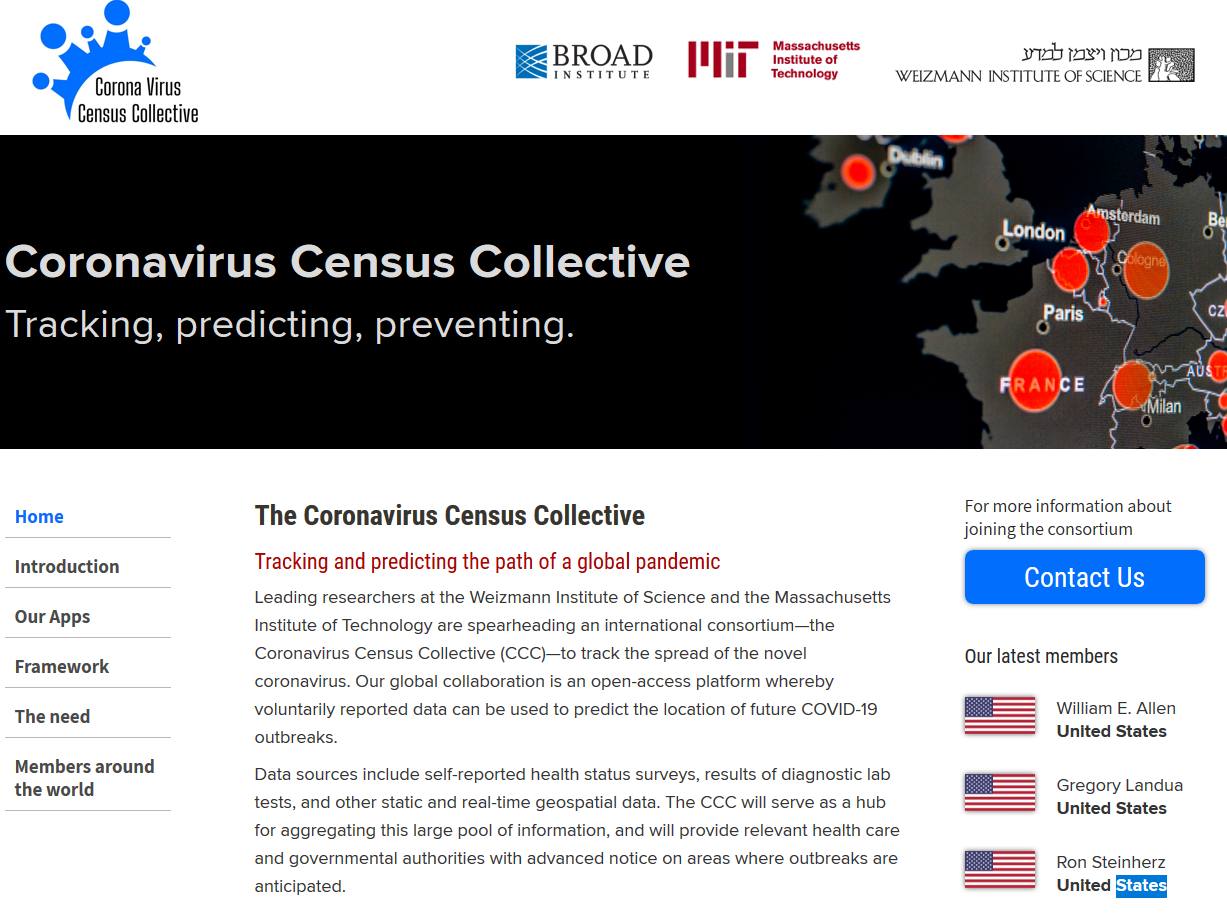
原文翻译自 Building an International Consortium for Tracking Coronavirus Health Status 。 上图为新冠病毒普查组织官方网页。
作者:Eran Segal, Feng Zhang, Xihong Lin, Gary King, Ophir Shalem, Smadar Shilo, William E. Allen, Yonatan H. Grad, Casey S. Greene, Faisal Alquaddoomi, Simon Anders, Ran Balicer, Tal Bauman, Ximena Bonilla, Gisel Booman, Andrew T. Chan, Ori Cohen, Silvano Coletti, Natalie Davidson, Yuval Dor, David A. Drew, Olivier Elemento, Georgina Evans, Phil Ewels, Joshua Gale, Amir Gavrieli, Benjamin Geiger, Iman Hajirasouliha, Roman Jerala, Andre Kahles, Olli Kallioniemi, Ayya Keshet, Gregory Landua, Tomer Meir, Aline Muller, Long H. Nguyen, Matej Oresic, Svetlana Ovchinnikova, Hedi Peterson, Jay Rajagopal, Gunnar Rätsch, Hagai Rossman, Johan Rung, Andrea Sboner, Alexandros Sigaras, Tim Spector, Ron Steinherz, Irene Stevens, Jaak Vilo, Paul Wilmes, CCC (Coronavirus Census Collective)
译文最早分享于“Sociological理论大缸”公众号
从个人和全球层面来看,信息都是我们抗击流行病最得力的防护武器。对个人而言,信息可以帮助我们做决策,并为我们提供安全感。对全球共同体而言,信息可以为政策制定提供依据,并为COVID-19疾病的流行提供关键见解。然而,要充分发挥信息的力量,需要数据规模巨大并且可以被访问。为实现这一目标,我们正行动起来成立一个国际联盟——新冠病毒普查组织(Coronavirus Census Collective,简称CCC),该组织将形成一个枢纽机构,以整合多种数据源信息,使之可被用于理解、监控、预测和防治全球性流行疾病(图1)。这些数据源可能包括通过调查(包括移动应用程序)采集的自报(self-reported)健康状况、诊断实验室的检测结果以及其他静态和实时的地理空间数据。这项跟踪和共享信息的集体努力将在以下方面起到不可估量的作用:预测疾病爆发的热点地区、识别哪些因素控制了传播速度、为即时政策决定提供信息、评估卫生组织控制流行病的措施有效性,以及提供有关新冠病毒致病源的关键见解等。它还将有助于个人及时获悉当前瞬息万变的情况,并助力于减缓疾病蔓延的其他全球性努力。
在过去几周时间里,世界各地已采取若干积极举措,利用每日自报症状数据作为追踪疾病传播、预测疫情发生地点、指导人口措施(guide population measures)及帮助分配卫生保健资源。本文的目的正是倡议对这些努力行动进行规范,并发起一项协同工作(collaborative effort),在确保参与者隐私得到保护的同时,促进全球利益最大化。
周雪光访谈:新型冠状病毒危机曝露中国治理的根本性紧张
原文翻译自The Walter H. Shorenstein亚太研究中心访谈 Coronavirus Crisis Exposes Fundamental Tension in Governing China, Says Stanford Sociologist and China Expert Xueguang Zhou 。
作者:Noa Ronkin, Xueguang Zhou(周雪光)
下文Noa Ronkin简称Ronkin, Xueguang Zhou简称Zhou
组织社会学可能并非是人们探求公共卫生危机起源的首要学术领域,比如这次由武汉冠状病毒引起的危机。但在专长当代中国制度变迁的斯坦福大学社会学家周雪光来看,这次危机紧迫的征兆(the writing on the wall)早在那里有目共睹。周雪光也是经济发展系Kwoh-Ting Li讲席教授和FSI的高级研究员,专攻领域为中国的组织、国家建设和官僚体制。他的研究揭示了中国治理的特点及紧张局势,对理解冠状病毒危机的演变及中国政府的应对很有意义。
在接下来的采访中,周雪光谈到了这些问题。他的研究贯穿中国治理的制度基础以及中国当前面临的挑战。为节约篇幅和使行文简洁,以下对话经过编辑。
Ronkin:中国大陆的冠状病毒死亡人数持续上升,人们对政府应对疫情的措施感到激愤。这场危机对中国的治理而言意味着什么?
Zhou:这次危机不仅是一种新型病毒的爆发,也是中国治理结构溃败(breakdown of China’s governance structures)的表现。这场危机曝露了体制中的裂缝(cracks in the system)。当然,任何政府都可能没有做好充分准备来应对这样一场新疫情的爆发。然而,根据我们目前所了解的,新病毒在爆发前几周已在武汉被检测到的,但是几级官僚机构没有起作用,有关当局也没有进入高度警戒状态。
我不会将责任归咎于任何地方官员,他们一直遵循着同样的危机应对模式。出于文化和政治方面的原因,他们主要关心的是在春节前几周和省人大年会前夕的社会安定和维稳。这种应对模式已在中国官僚机构中建立了多年。但在当前情况下,这类默认行为方式(default behavior)则曝露了中央和地方政府的弱点。我们可以想象中国其他省市也在发生类似的公共卫生危机和各类问题,因为那些地方官员们也秉持同样的心态。问题不在于这里或那里的个别官员,而是普通官僚机构已经被驯服,并且以这种方式回应不和谐信息。
我希望这场危机成为一个转折点:冠状病毒危机的严重性足以深深地触动人们的生活,使人们意识到需要改变的过去那种治理状况。我希望人们认识到,政府必须改善其决策过程、透明度和对社会投入的开放程度。我国现行的治理体系是为自上而下的决策执行而设计的,而非自下而上的信息共享和传递。因此,即使信息是充分的——就像冠状病毒的情况一样——也没有实现从地方到上层的有效传递。后者无法应对来自国土辽阔、人口众多、异质性强的国家的信息负荷。事实上,高级官员试图保护自己,过滤掉信息,而不是公开他们无法处理的情况。
与Erik Wright促膝长谈(四):再议分析马克思主义
图片选自美国左翼政论杂志 《雅各宾(Jacobin)》 。
作者:Erik Olin Wright, Mark Kirby
Kirby:在你的文章《什么是分析马克思主义》中,你曾说分析马克思主义小组每年九月都会聚在一起,他们自称是“不扯淡的马克思主义组织(no-bullshit Marxism group)”。在你看来,你觉得需要摆脱的“扯淡(bullshit)”到底是什么?这个小组又是如何确保自己能够避免这种“扯淡(bullshit)”?
Wright:当然,“不扯淡的马克思主义小组”这个标签有点自嘲,但它确实触及了一个严肃的问题(实际上,Cohen就“什么是学术扯淡?”这个主题写过一篇有趣而深邃的文章)。全盛时期的“扯淡”马克思主义有三宗罪:
与Erik Wright促膝长谈(三):分析马克思主义
图片选自 Matt Vidal的flickr账号 。Wright教授在与学生们BBQ。
作者:Erik Olin Wright, Mark Kirby
Kirby:你经常引用John Roemer的文献。你认为是他让你转向了劳动价值论(labour theory of value)和分析马克思主义(analytical Marxism)。你到底同意他的哪些观点?你俩之间有什么区别?如果有的话。
Wright:我不会用这种方式来形容我和John Roemer作品之间的关系。我之所以转向分析马克思主义,是因为我欣赏那种对马克思主义问题进行严谨和细致的思考,而这种思考正是分析马克思主义圈子工作的特点。这个圈子中,G. A. Cohen可能是最重要的,其次是Adam Przeworski和John Roemer。我认为,在我发现分析马克思主义是一种别致的理论流派前,我自己的研究工作就已经具备这些一般特征。在任何情况下,问题不在于他们对个别论题的具体论点,比如劳动价值论的优点,而是他们提出论点的总体策略(general strategy)。
到了1981年,我就成为这个知识小组的积极参与者。在我们早期研究课题中,我们关心的一个问题是如何正确理解“剥削”的概念以及其与劳动价值论的关系。当然,John Roemer就是我们中的一员。但其他人对此也有许多看法。通过讨论,分析马克思主义小组的所有成员都确信,劳动价值论的技术工具是不能令人满意的——它根本不能做到它原本打算从事的理论工作。但我们也逐渐认识到,为了阐述一个连贯的剥削概念及其与阶级分析的联系,劳动价值论也是不必要的。
如果我必须总结我的工作和方法,包括与John Roemer,与分析马克思主义小组其他成员的工作和方法之间的区别,我会强调如下四点: