第九讲 抽样分布、区间估计与均值检验
从理论到实践
辅助知识点: 在上一讲中,我们通过模拟,直观地理解了总体、样本和抽样分布这三大核心概念。
本讲我们将学习
- 精确计算这三个分布的关键参数(均值、方差、标准差/标准误)。
- 利用我们手中的一个样本,对未知的总体参数进行区间估计(Confidence Interval)。
- 基于样本证据,对关于总体均值的某个断言进行科学的假设检验 (Hypothesis Testing)。
0. 预处理
- 设置工作目录
| |
- 导入2016年中国劳动力动态调查数据 (CLDS)
| |
1. 计算总体分布、样本分布及抽样分布
我们将以2015年总收入 (I3a_6) 为例,通过一个清晰的流程,来计算总体、样本及抽样分布的参数。
场景设定
- 首先将完整的CLDS数据集视为“总体”。
- 然后从中随机抽取一个样本 (n=500)。
- 最后计算理论上的抽样分布参数。
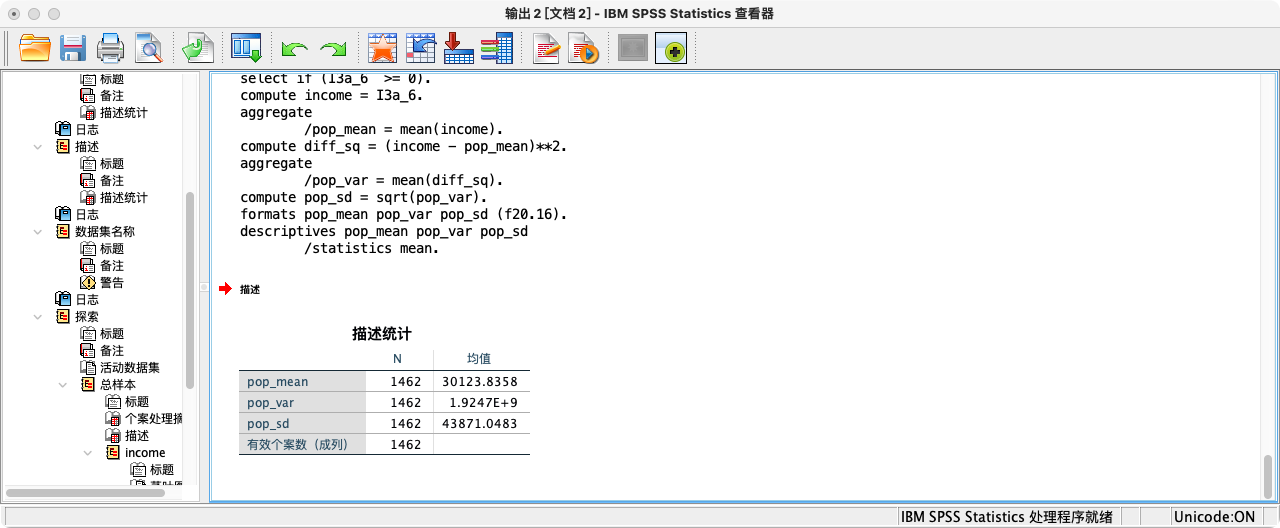
第一步:计算总体参数 (Population Parameters)
- 我们先筛选出有效数据,并计算其真实的均值(μ)、方差(σ²)和标准差(σ)。
- 注意:此时CLDS数据集相当于总体数据集。
| |
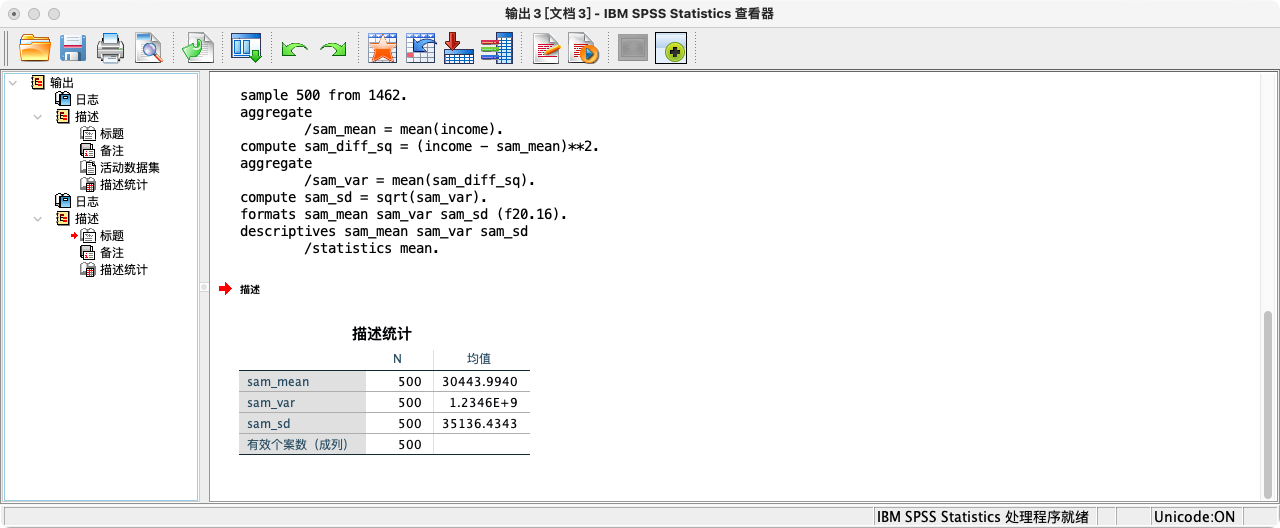
第二步:抽取样本,并计算样本统计量 (Sample Statistics)
- 现在我们从“总体”的1462个对象中,抽取一个n=500的样本。
| |
- 第三步:计算抽样分布的参数 (Sampling Distribution Parameters)
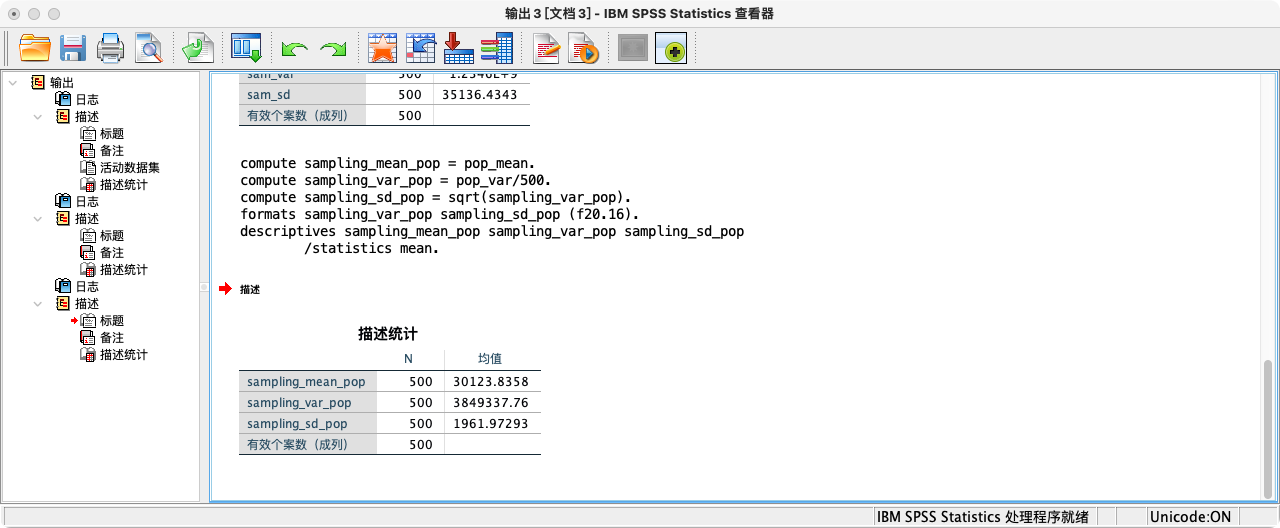
- 情况一:当总体已知时 (理论情况)
- 抽样分布的均值(μ_x̄)等于总体均值(μ)。
- 抽样分布的方差(σ²_x̄)等于总体方差(σ²)除以样本量n。
- 抽样分布的标准差,即标准误 (Standard Error, SE),等于总体标准差(σ)除以√n。
| |
- 情况二:当总体未知时 (现实情况)
- 在现实中,我们没有总体参数,只能用样本统计量来估计抽样分布的参数。
- 方法A:手动计算 (应用贝塞尔校正)
辅助知识点:贝塞尔校正 (Bessel’s Correction) 当我们使用样本方差来估计总体方差时,直接计算的样本方差(分母为n)会倾向于低估真实的总体方差。为了得到一个更准确的无偏估计,我们需要将分母从
n调整为n-1。这就是贝塞尔校正。
| |
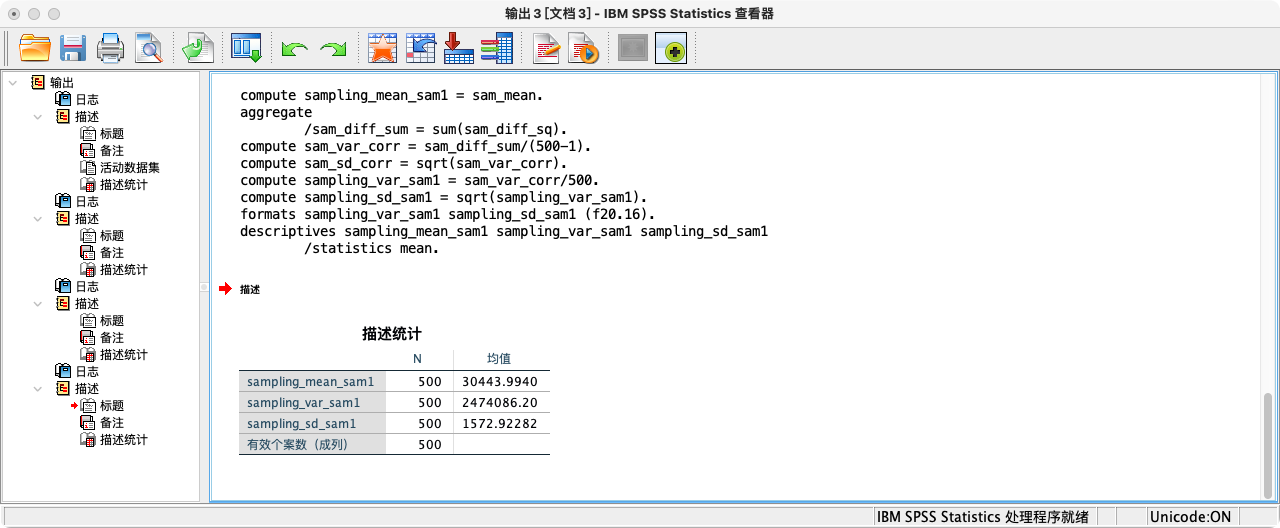
- 方法B:利用SPSS内置命令与输出管理系统(Output Management System,OMS)
- SPSS的
DESCRIPTIVES等标准命令在计算标准差和方差时,默认已经进行了贝塞尔校正(即分母为n-1)。它计算出的“均值标准误(SEMEAN)”就是我们需要的s / sqrt(n)。我们可以用输出管理系统(OMS)将这个结果直接捕获为一个新数据集。
- SPSS的
辅助知识点:输出管理系统 (Output Management System, OMS)
什么是OMS?
输出管理系统 (OMS) 是SPSS中一个非常强大的高级功能。通常情况下,我们运行一个分析命令(如
FREQUENCIES),它的结果会以表格和图形的形式显示在“输出查看器”窗口中。这些结果是“死的”,我们只能看,不能直接用于再分析。OMS 的作用就是充当一个“捕获器”或“拦截器”。它可以在结果被发送到输出查看器之前,将其拦截下来,并按照我们的指令,将这些表格转换成一个SPSS数据文件 (.sav)。
为什么要用OMS?
想象一下,你想比较100个不同变量的均值。如果用常规方法,你需要运行100次
DESCRIPTIVES,然后手动将100个均值从输出窗口抄写或复制到一个新的数据文件中。这个过程不仅繁琐,而且极易出错。使用OMS,你只需要编写一个简单的语法块,运行这100次
DESCRIPTIVES,OMS就会自动为你创建一个包含这100个均值的新数据集。这在进行元分析、模拟研究或需要对分析结果进行二次处理时,是不可或缺的利器。关键使用技巧:切换输出语言
在使用OMS将结果保存为数据文件之前,强烈建议将SPSS的输出语言临时切换为英语。
- 点选操作:编辑 → 选项 → 语言 → 在“输出”下拉菜单中选择“English”。
- 原因:如果使用中文输出,OMS生成的数据集中的变量名可能会是中文(例如“均值”、“标准差”)。虽然这在SPSS中可行,但在后续的语法编写或与其他软件交互时,使用英文变量名(如
Mean,StdDeviation)会更加标准和方便,避免潜在的编码问题。
语法操作:OMS 的工作模式就像一个三明治:OMS命令是顶部的面包片,OMSEND是底部的面包片,中间夹着的是你想要捕获其结果的常规分析命令。
| |
语法说明
OMS ... OMSEND.这是一个成对出现的命令块。OMS标志着捕获开始,OMSEND标志着捕获结束。所有在这两者之间的命令的输出,都会被OMS系统进行处理。/SELECT [内容类型]指定你想要捕获的输出内容的主要类型。TABLES: 表格 (这是最常用的选项)。HEADINGS: 标题文本。CHARTS: 图形。MODELS: 模型(如回归模型的摘要)。WARNINGS: 警告信息。
/IF COMMANDS=["命令列表"] SUBTYPES=["子类型列表"]这是一个过滤器,用于精确指定你只想捕获哪些命令的哪些特定表格。COMMANDS: 指定你感兴趣的命令名称,例如["Descriptives"],["Frequencies"],["T-Test"]。SUBTYPES: 指定该命令输出的众多表格中,你具体想要哪一个。- 如何找到正确的
SUBTYPES名称? 这是使用OMS最关键的一步。- 先正常运行一次你想捕获的命令(例如
DESCRIPTIVES income.)。 - 在输出查看器中,找到你想要捕获的那个表格。
- 右键点击该表格的标题(在左侧大纲视图中),选择**“复制OMS命令标识符”和“复制OMS表格子类型”**,然后粘贴到你的语法中。
- 先正常运行一次你想捕获的命令(例如
/DESTINATION FORMAT=<格式OUTFILE="<文件名>"指定捕获到的内容要以何种格式保存到哪个文件中。FORMAT:SAV: SPSS数据文件 (最常用)。XLSX: Excel文件。PDF: PDF文档。HTML,TEXT等。
OUTFILE: 指定保存的路径和文件名。
综合示例:捕获DESCRIPTIVES命令的描述统计表
目标:我们想运行
DESCRIPTIVES命令来计算变量income的均值、标准差等,并希望将输出的“描述统计”表格直接保存为一个名为my_descriptives.sav的新数据集。语法实现
| |
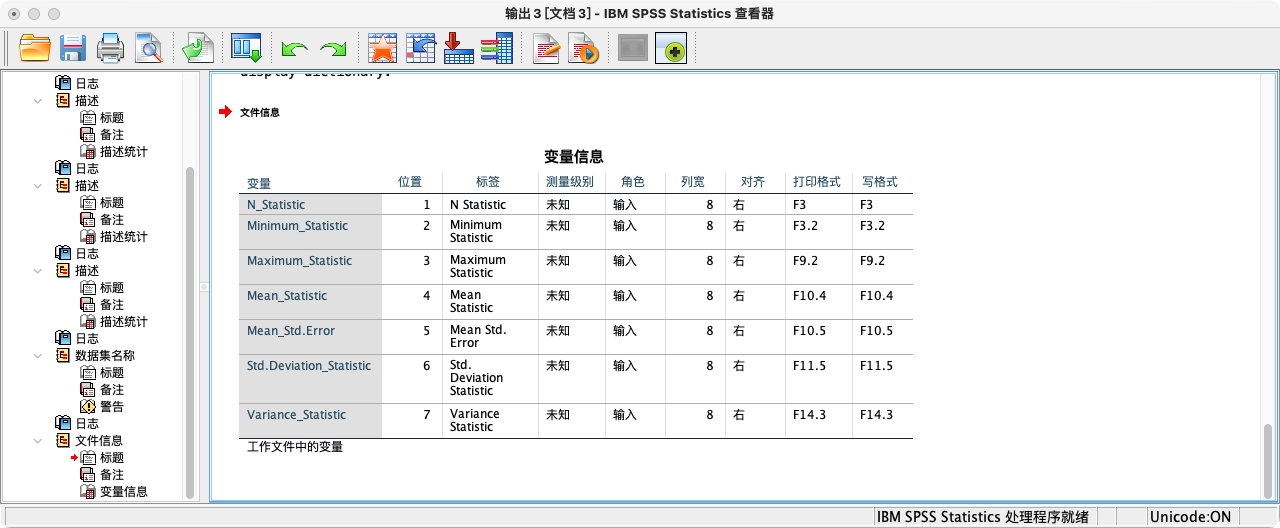
- 接下来我们将语法DESCRIPTIVES计算income的结果存储为数据。
| |
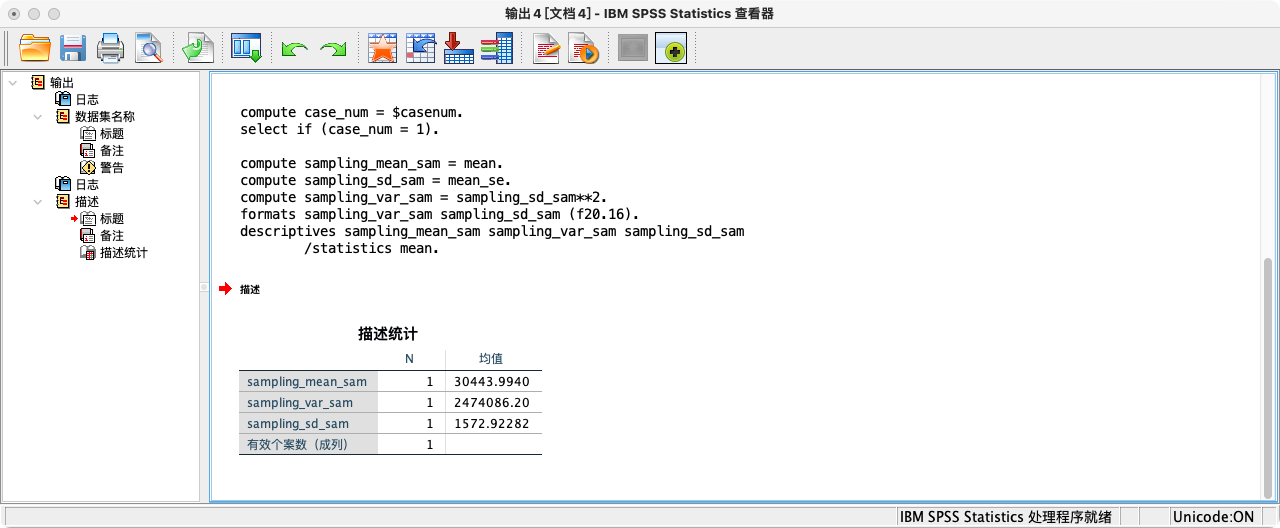
可以发现,手动计算和OMS方法得到的结果是完全一致的。
2. 根据样本信息,对总体进行区间估计
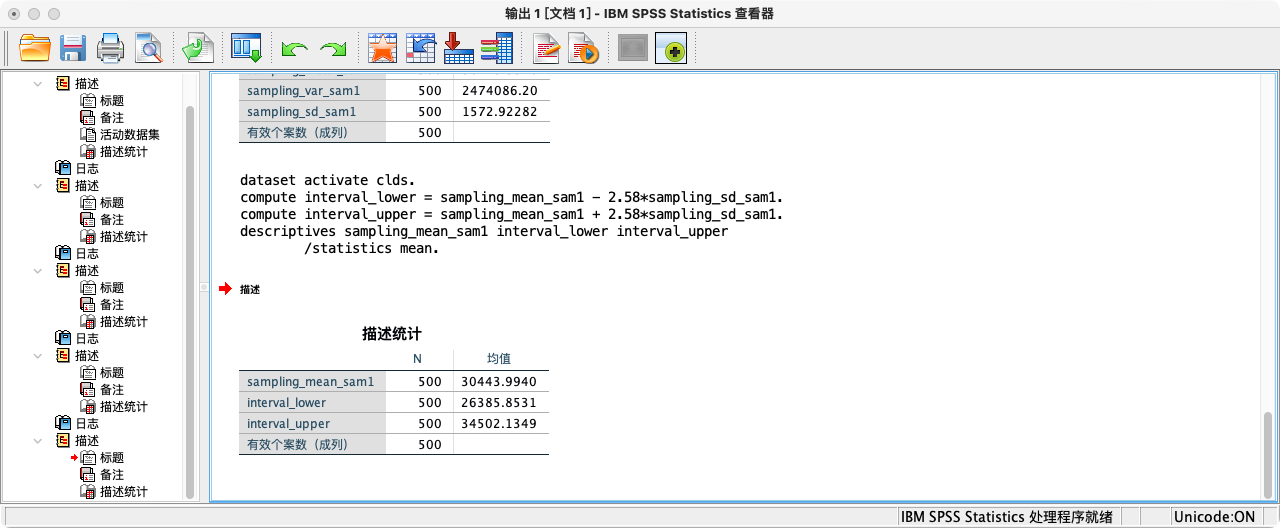
利用我们计算出的样本均值和标准误,我们可以为未知的总体均值构建一个置信区间。
案例背景:继续使用n=500的收入样本,计算总体平均收入的99%置信区间。
方法一:手动计算
- 公式:
样本均值 ± (给定置信度下的Z临界值 * 标准误) - 对于99%置信度,大样本(n>30)下的Z临界值约为2.58。
- 公式:
| |
- 方法二:使用
EXAMINE命令 (推荐)
| |
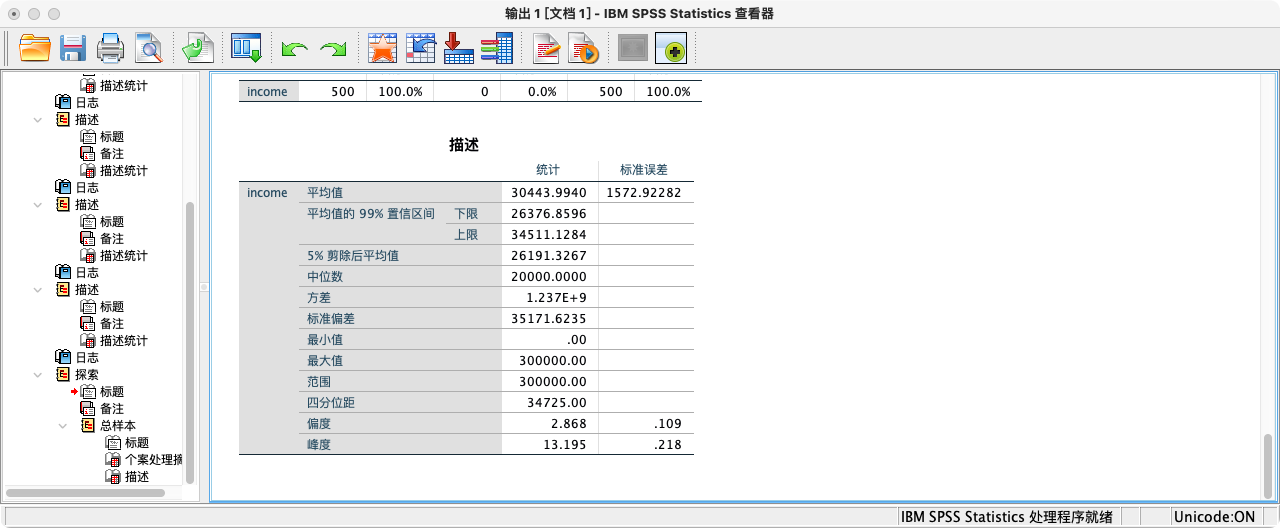
方法三:使用拔靴法 (Bootstrap) 修正
辅助知识点:为何使用拔靴法(Bootstrap)? 传统方法计算置信区间依赖于“抽样分布为正态分布”的理论假设。如果样本数据分布很不规则(如极度偏态、有极端值),这个假设可能不成立。拔靴法是一种强大的计算机模拟技术,它通过对现有样本进行上千次“有放回的再抽样”,来经验性地构建一个抽样分布,并据此计算置信区间。这个过程不依赖于正态假设,因此结果更为稳健(robust)。
点选操作:分析 → 描述统计 → 探索 → 在左侧变量列表中选择变量 → 选择统计 → 勾选描述并填入置信区间 → 继续 → 自助抽样 → 勾选执行自助抽样(填入样本数小于原始样本数) → 填入置信区间 → 继续 → 确定;
语法操作:
BOOTSTRAP命令本身不产生任何输出。它的作用像一个“开关”或“前缀”,用于声明紧随其后的那个分析命令(如T-TEST,REGRESSION,MEANS等)需要使用拔靴法来计算其标准误和置信区间。
| |
语法说明
BOOTSTRAP- 这是命令的起始标志。
/SAMPLING METHOD=SIMPLE- 指定抽样方法。
SIMPLE(简单有放回抽样)是默认且最常用的选项。
- 指定抽样方法。
/VARIABLES指定在拔靴法抽样过程中需要关注的变量。TARGET: 指定因变量或分析的核心目标变量。INPUT: 指定自变量或分组变量。在某些分析中(如独立样本T检验、回归分析)必须指定。
/CRITERIA设置拔靴法运行的准则。CILEVEL: 指定要计算的置信度,通常为95或99。CITYPE: 指定计算置信区间的方法。PERCENTILE(百分位法)和BCa(偏态校正加速法)是两种常用且推荐的方法。NSAMPLES: 指定要生成的自助样本的数量。这个数值越大,结果越稳定,但计算时间也越长。通常推荐设置为1000到5000之间。
| |
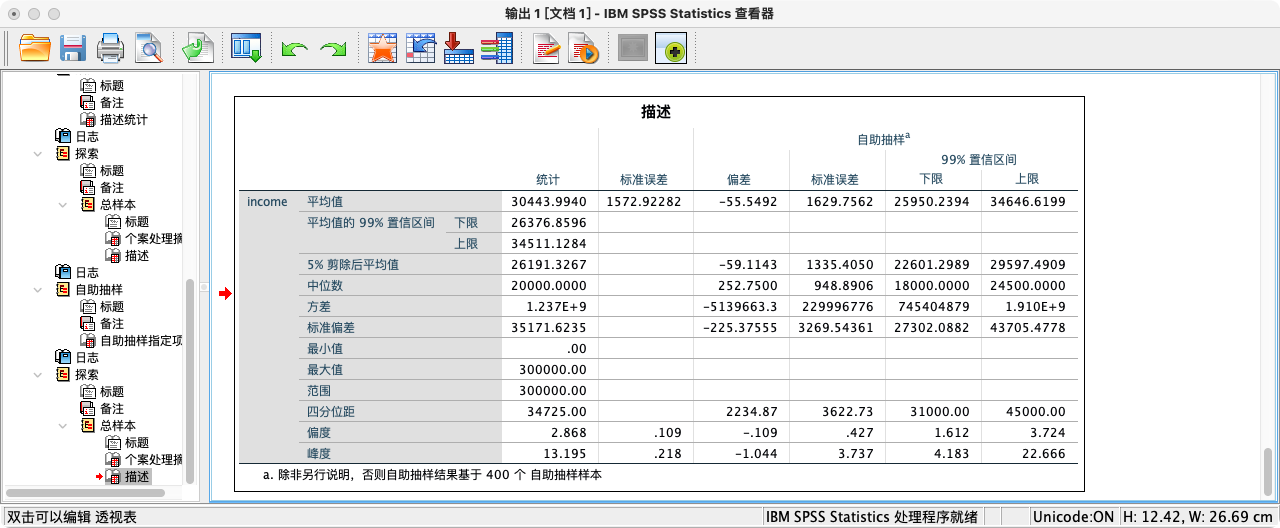
- 注意观察拔靴法生成的置信区间(在Bootstrap表格中)与传统方法计算的区间(在Descriptives表格中)的差异。
随堂练习
- 以生活幸福感(
I7_6_1)作为变量,随机抽取400个样本(随机种子为20200501)。在总体情况未知的前提下,计算样本均值、(校正后的)样本方差,并估计出标准误。 - 利用该样本,计算生活幸福感总体均值的95%置信区间。
3. 绘制抽样分布图和区间分布图
- 注意:以下为Stata命令
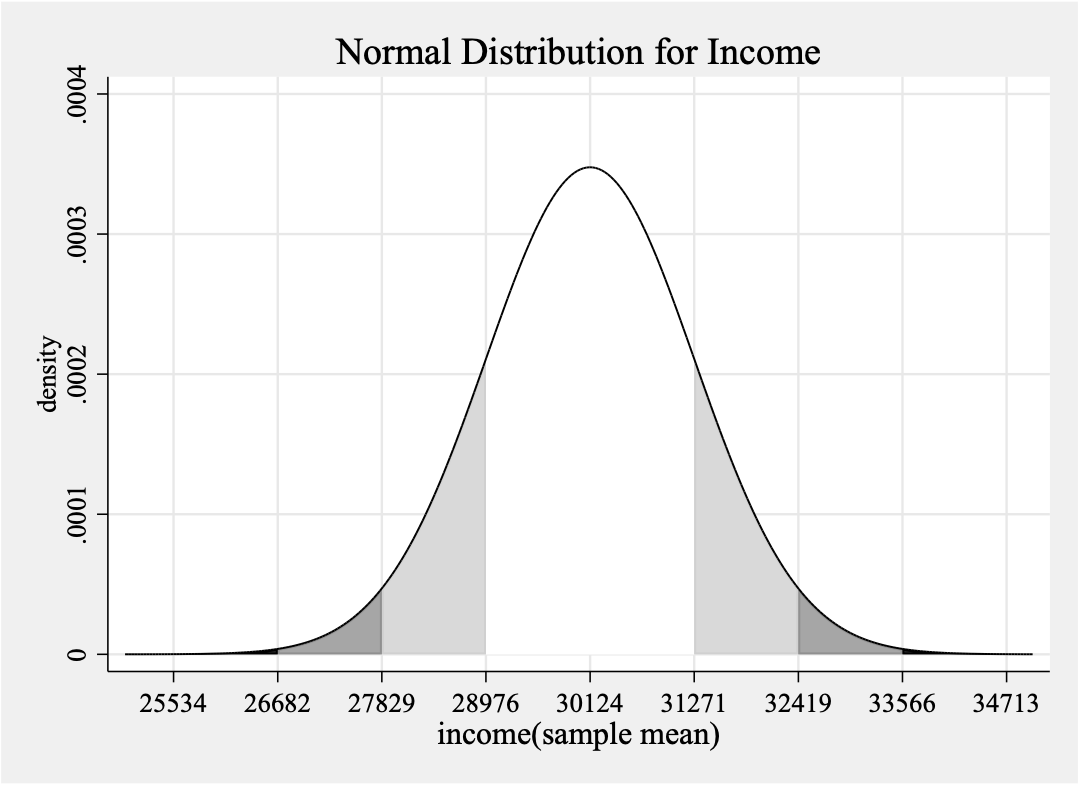
- 抽样分布图
| |
| |
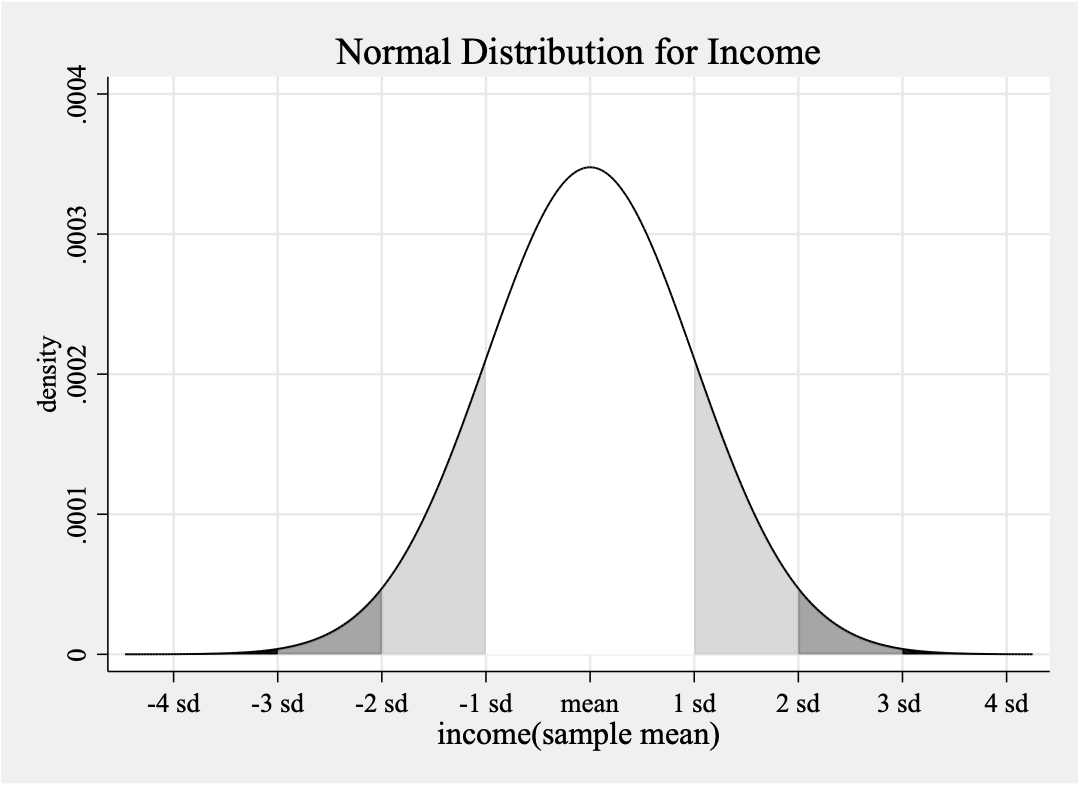
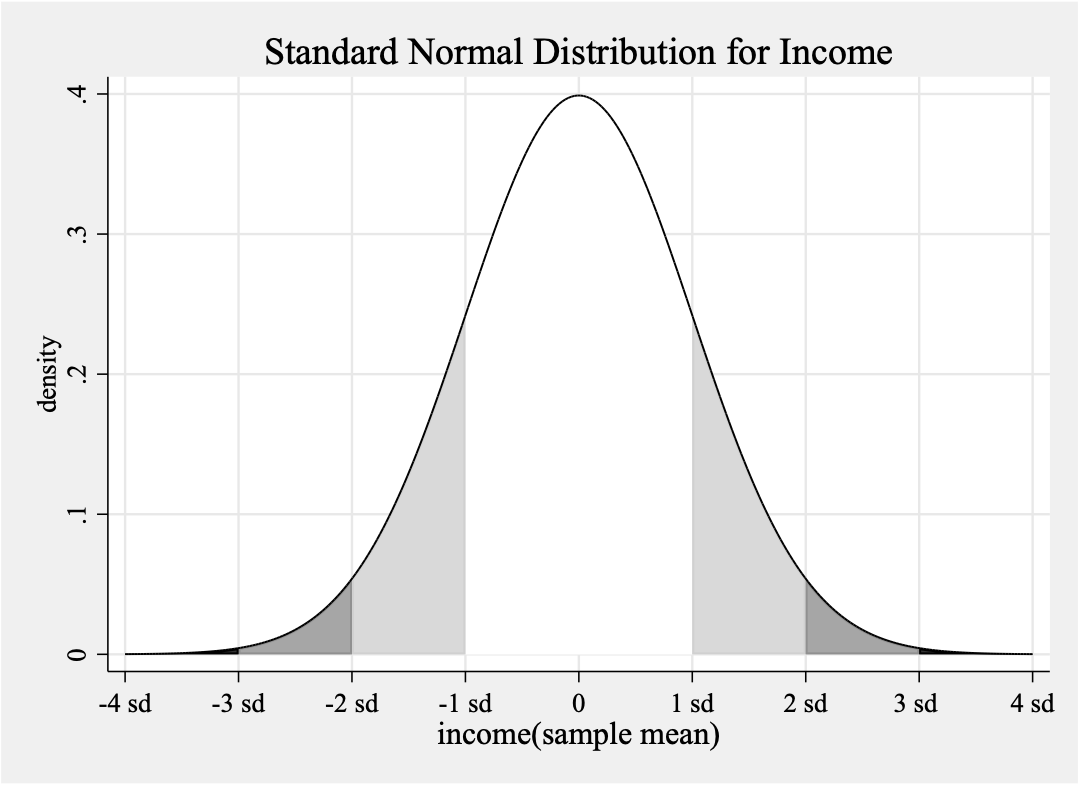
- 标准正态分布
| |
- 绘制区间分布图
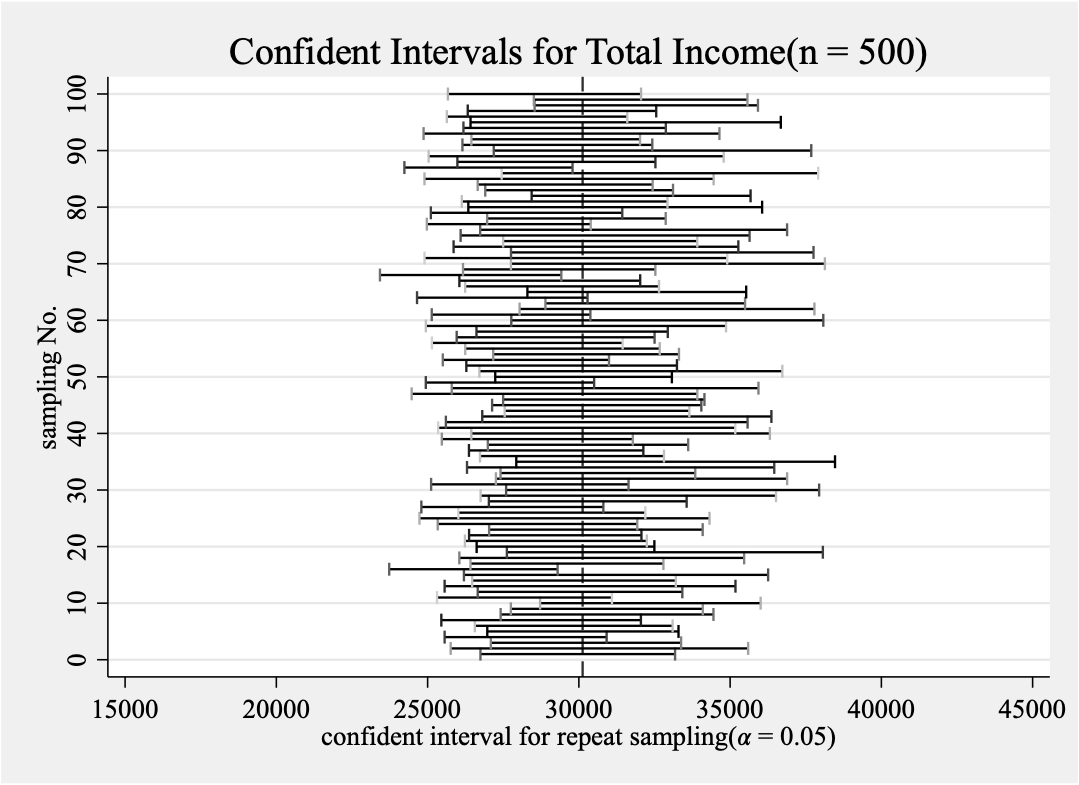
| |
- 将重复抽样结果绘制在同一张图上
| |
4.编制均值表
- 均值表
MEANS命令是SPSS中用于分组计算描述性统计量的快捷工具。它的核心功能是为一个或多个连续变量(因变量),按照一个或多个分类变量(自变量)的分组,来计算其均值、标准差、样本量等统计指标。 MEANS与FREQUENCIES/DESCRIPTIVES的区别FREQUENCIES和DESCRIPTIVES主要用于单个变量的整体描述。MEANS则专注于探索变量之间的关系:一个分类变量如何影响一个连续变量的均值。它是进行T检验和方差分析(ANOVA)之前,进行数据探索的理想工具。
- 点选操作:分析 → 比较平均值 → 平均值 → 在左侧变量列表中选择变量(若分组,在层中选择分组变量) → 点击“选项” → 选择统计量 → 继续 → 可选自助抽样 → 勾选执行自助抽样(填入样本数小于原始样本数) → 填入置信区间 → 继续 → 确定
- 语法操作:
| |
MEANS TABLES = dependent_var BY group_var1 ...这是命令的主体,用于定义表格的结构。dependent_var: 指定一个或多个你想要计算其统计量的连续变量(因变量)。BY: 这是一个关键字,用于引出分组变量。group_var1: 指定一个或多个用于分组的分类变量(自变量)。- 如果省略
BY和分组变量,MEANS命令将只计算整个数据集的描述统计量。
/CELLS用于指定你希望在输出表格的单元格中显示哪些统计量。MEAN: 均值 (默认)。COUNT: 个案数/样本量 (默认)。STDDEV: 标准差 (默认)。VAR: 方差。SEMEAN: 均值标准误。MIN: 最小值。MAX: 最大值。SUM: 总和。SKEW: 偏度。KURT: 峰度。ALL: 显示所有可用的统计量。DEFAULT: 显示默认的三个统计量 (MEAN,COUNT,STDDEV)。
案例(4-1):编制2015年总收入均值表
- 导入2016年中国劳动力动态调查数据和构造income变量
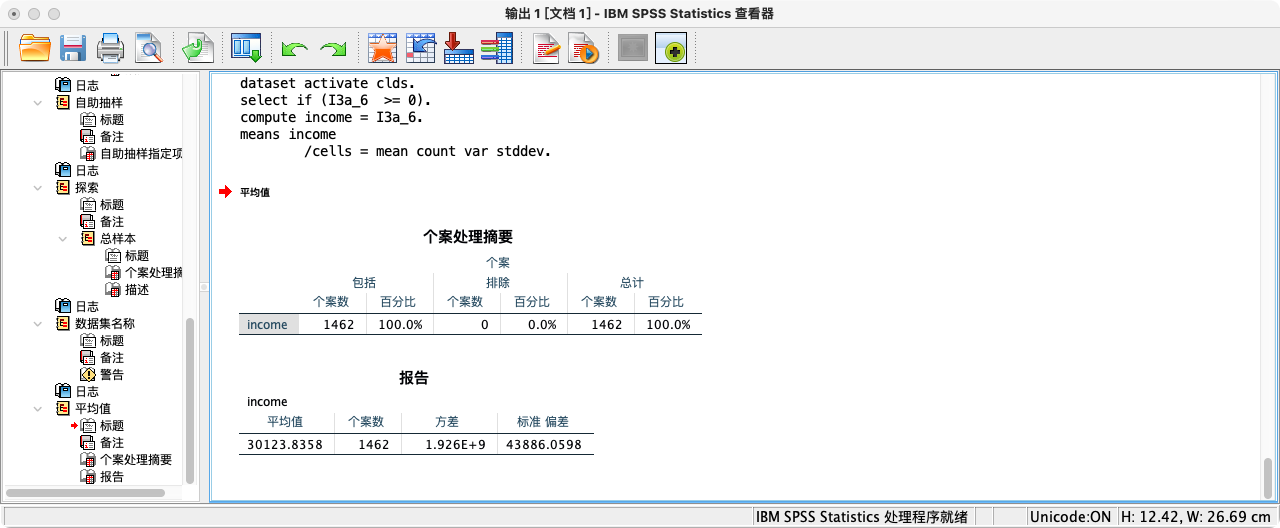
- 查看2015年总收入的均值、样本量、方差和标准差
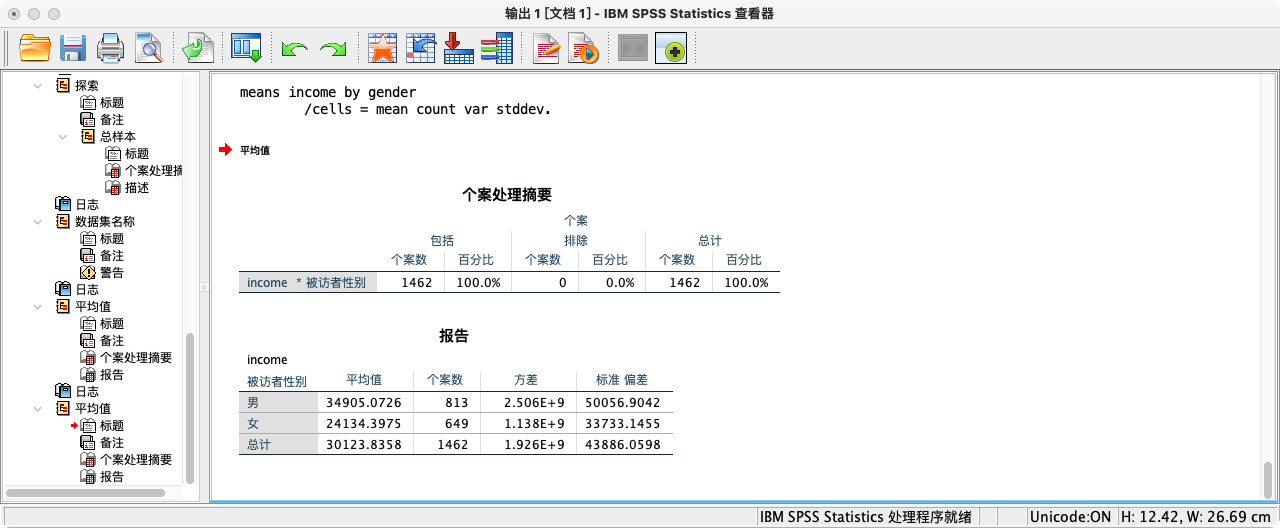
- 按性别分组描述
- 均值表附加功能:用拔靴法计算置信区间
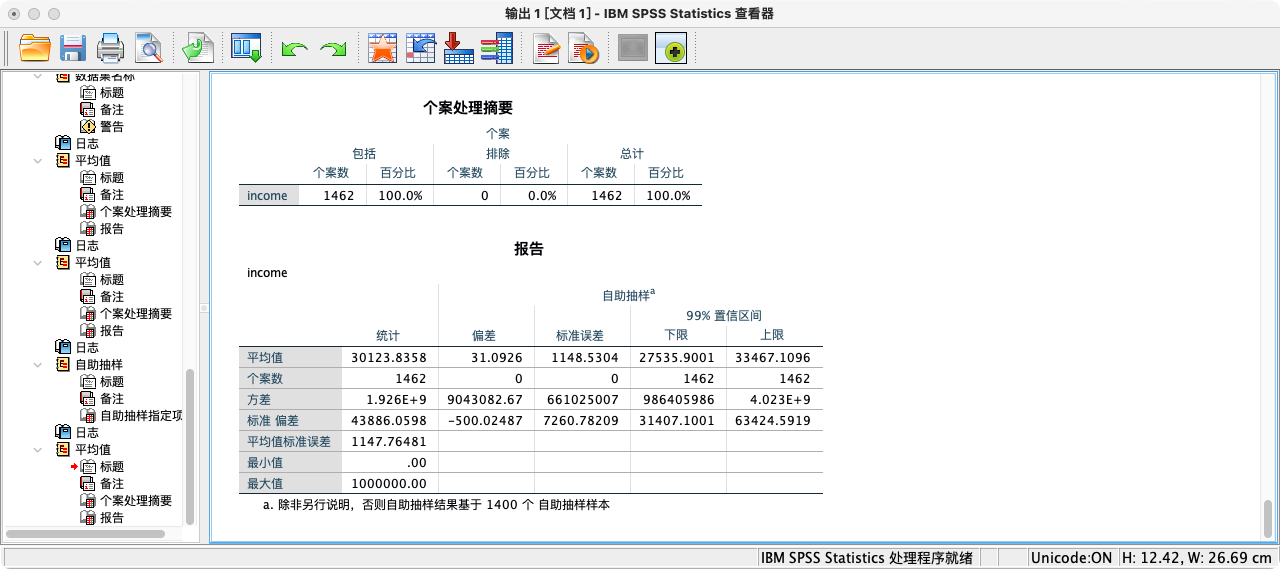
随堂练习:按性别分组呈现最高教育程度(I2_1)的基本统计信息
5. 单样本均值T检验
核心问题:我们手中的样本均值,是否支持“总体均值等于某个特定数值”的说法?
假设检验的逻辑:我们先假设“总体均值确实等于那个特定值”(即虚无假设 H₀),然后计算我们手中的样本结果在这种假设下出现的概率(p-value)。如果概率极低(通常p < 0.05),我们就推翻这个假设。
案例:根据CLDS整个数据集(注意,现在我们将其视为一个样本),在99%的置信水平下,判断中国劳动力2015年总收入的总体均值是否等于25000元?
- H₀ (虚无假设):总体平均收入 μ = 25000元。
- H₁ (研究假设):总体平均收入 μ ≠ 25000元。
方法一:手动计算检验统计量 (理解内部原理)
- 我们计算一个t统计量(在大样本下近似Z统计量),它衡量了样本均值与假设的总体均值之间相差了多少个“标准误”。
- 第一种方法又可以通过三种方式判断
- 第一种方式:通过Z值判断(若Z值大于2.576,则拒绝原假设)
| |
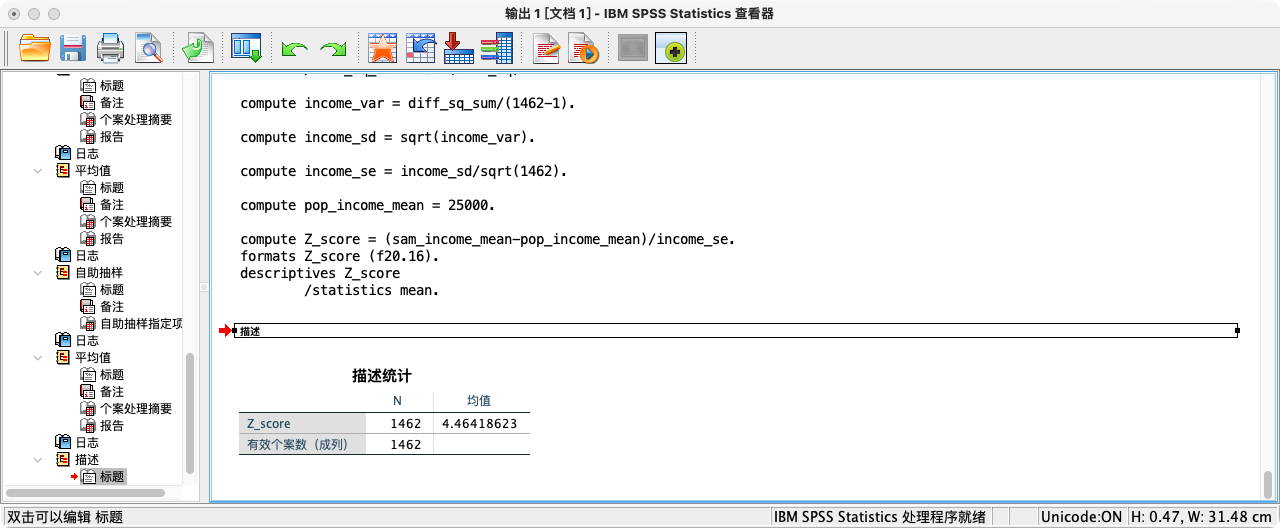
可知实际Z值(4.464186)大于99%置信区间的Z值(2.576),拒绝虚无假设.
- 第二种方式:通过置信区间判断(若99%置信度下得到的区间估计值不包含25000,则拒绝虚无假设)
| |
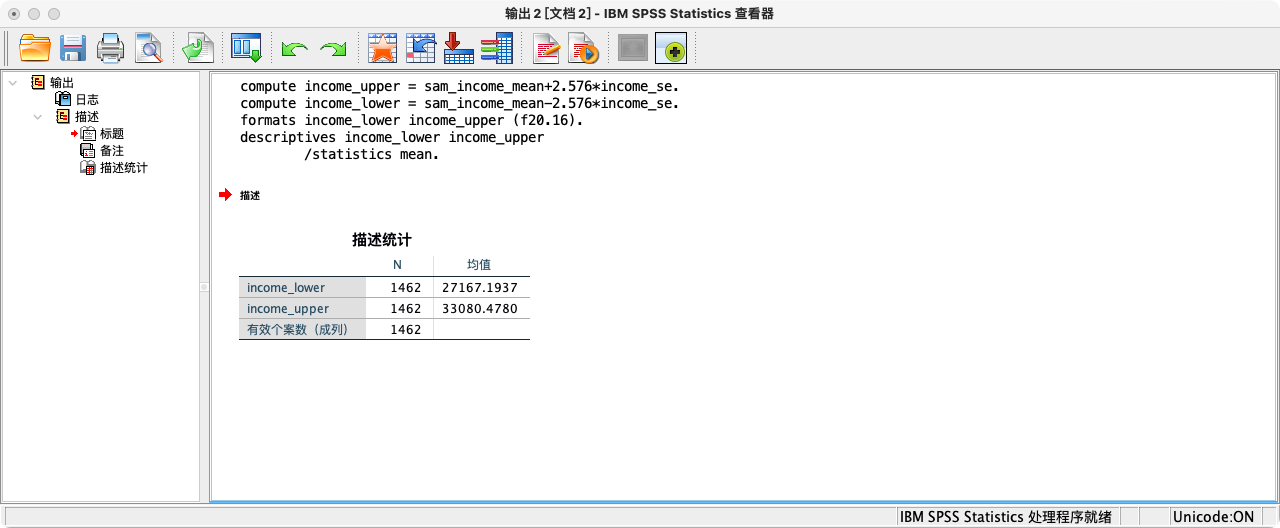
可知区间下限为27167.193698,不包含25000,拒绝虚无假设
- 第三种方式:通过p值判断(在99%置信区间下,p值若小于α即0.01,则拒绝虚无假设)
| |
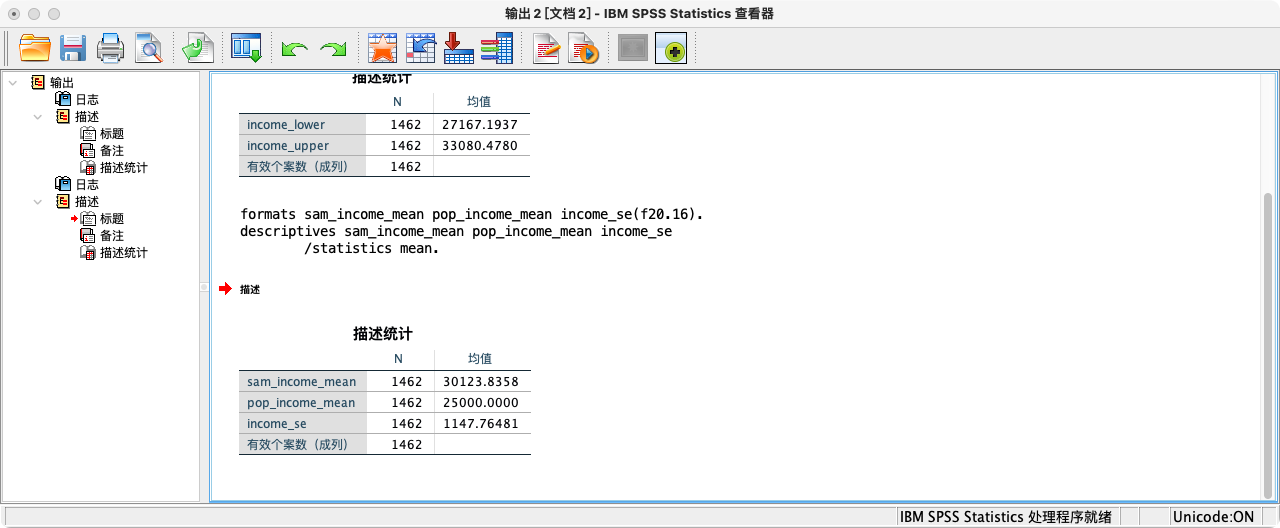
- 尽管大样本(n ≥ 30)的抽样分布为正态分布,但SPSS软件的总体均值检验默认将正态分布视作t分布的特例
- 根据t分布特性,在大样本情况下,t分布近似标准正态分布;随着样本规模增加,t分布越近似标准正态分布
- 因此,总体均值检验可以利用正态分布特性,也可以利用t分布特性
- 在正态分布下,P值等于整个正态分布的累积密度(面积=1)与样本均值处的累积密度(面积 = cdf.normal(样本均值,总体均值,抽样分布标准差)或cdf.normal(实际Z值,0,1))之差的2倍
- 在t分布下,P值等于整个t分布的累积密度(面积=1)与样本均值处的累积密度(面积 = cdf.t(实际Z值,自由度))之差的2倍
| |
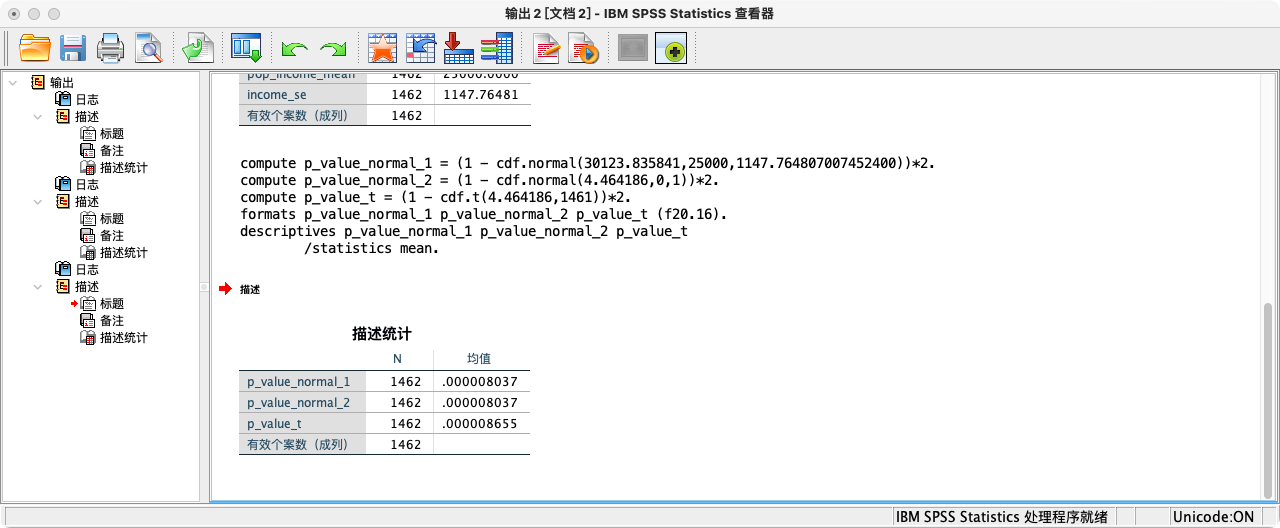
可知p值(=0.000008037或0.000008654714756)小于0.01,拒绝虚无假设
方法二:使用
T-TEST命令 (标准流程)点选操作:分析 → 比较平均值 → 单样本T检验 → 在左侧变量列表中选择检验变量 → 在“检验值”中填入总体均值 → 点击“选项” → 填入置信区间 → 继续 → 可选自助抽样 → 勾选执行自助抽样(填入样本数小于原始样本数) → 填入置信区间 → 继续 → 确定
语法操作:
| |
语法说明
T-TEST- 这是命令的起始标志。
/TESTVAL = <检验值>- 这是单样本T检验最核心的部分。你在这里指定一个具体的数值,这个数值就是你虚无假设 (H₀) 中声称的总体均值。
- 示例:如果我们想检验总体均值是否等于25000,就写
/TESTVAL = 25000。
/VARIABLES = <待检验变量>- 指定你想要进行检验的那个连续变量(即你的样本数据)。
- 示例:
/VARIABLES = income。
/CRITERIA = CI(<置信水平>)- 用于设定检验的标准。
CI代表Confidence Interval(置信区间)。- 括号内的数值是你想要的置信水平,通常为
0.95(95%) 或0.99(99%)。这对应于显著性水平α=0.05和α=0.01。 - 示例:
/CRITERIA = CI(0.95)。
/MISSING- 定义如何处理缺失值。
ANALYSIS: 按分析排除缺失值。即如果一个案在待检验变量上是缺失的,就将其从本次检验中排除 (默认)。LISTWISE: 按列表排除缺失值。如果一个案在/VARIABLES中指定的任何一个变量上是缺失的,就将其排除。在单样本检验中,ANALYSIS和LISTWISE的效果通常是相同的。
在这里,我们使用检验总体收入均值是否为25000元。
| |
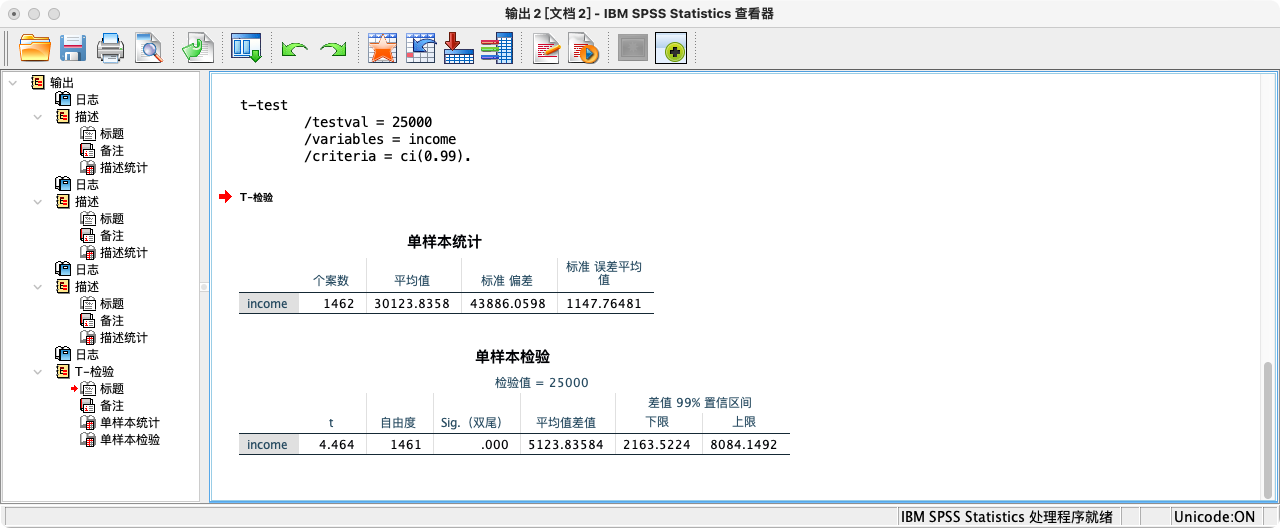
结果解读:查看“Sig. (2-tailed)”即p值。这里p值(0.000)远小于我们的显著性水平α (1-0.99=0.01),因此我们拒绝H₀。结论:样本证据强烈表明,总体平均收入不等于25000元。
方法三:采用拔靴法(从已有1462个样本不断重复抽取1400个样本)修正抽样分布标准误后,再进行假设检验
| |
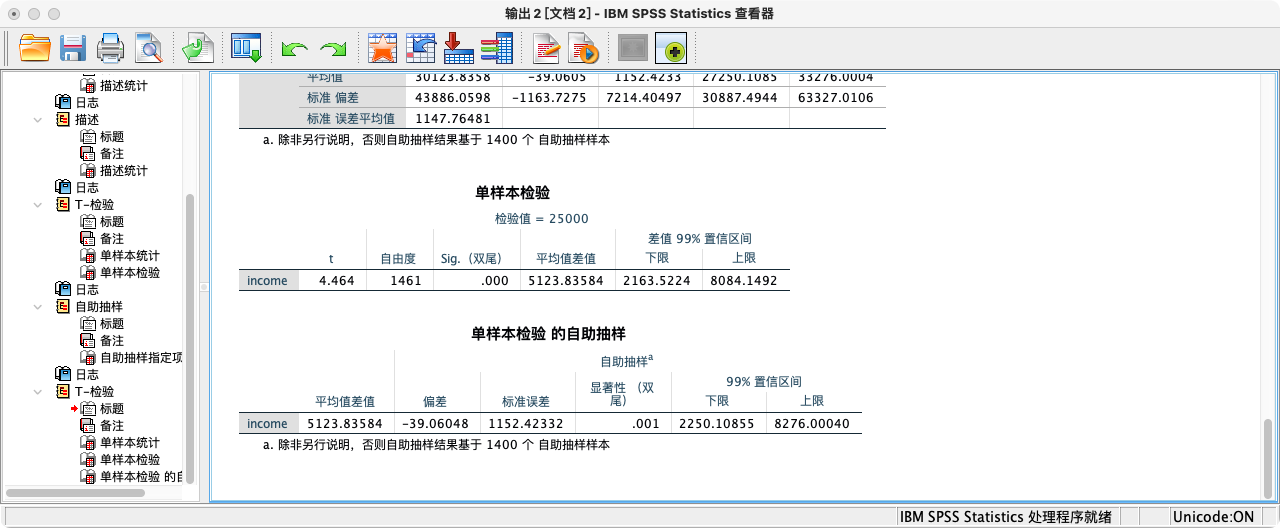
- 可知p值(=0.000714)小于0.01,拒绝虚无假设,接受研究假设
随堂练习:试检验2015年中国劳动者的平均最高教育程度(I2_1)是否等于8年,置信区间为95%
6. 独立样本均值T检验
- 核心问题:两个独立总体的均值是否存在差异?(例如,男性的总体平均收入与女性的总体平均收入是否相等?)
- 点选操作:分析 → 比较平均值 → 独立样本T检验 → 选择检验变量 → 选择分组变量(定义比较组时,填入变量取值)→ 选项(填入置信区间) → 继续 → 可选自助抽样 → 勾选执行自助抽样(填入样本数小于原始样本数) → 填入置信区间 → 继续 → 确定
- 语法操作:
| |
语法说明
T-TEST- 这是命令的起始标志。
GROUPS = <分组变量>(<组1的值<组2的值>)- 这是独立样本T检验最核心的部分,用于定义你要比较的两个组。
<分组变量>: 指定一个分类变量,这个变量的取值定义了不同的组别(例如gender)。(<组1的值<组2的值>): 在括号中,明确指定你想要进行比较的两个组的具体数值。- 示例1 (数值型): 如果在
gender变量中,1代表男性,2代表女性,那么应该写成GROUPS = gender(1 2)。 - 示例2 (字符串型): 如果分组变量是字符串,需要用单引号括起来,例如
GROUPS = group('Control' 'Treatment')。
- 示例1 (数值型): 如果在
- 注意: 传统的
T-TEST命令一次只能比较两个组。
/VARIABLES = <检验变量>指定你想要比较其均值的那个连续变量。- 示例:
/VARIABLES = income。
- 示例:
/CRITERIA = CI(<置信水平>)用于设定检验的标准和输出的置信区间。CI代表Confidence Interval(置信区间)。- 括号内的数值是你想要的置信水平,通常为
0.95(95%) 或0.99(99%)。 - 示例:
/CRITERIA = CI(0.95)。
/MISSING定义如何处理缺失值。ANALYSIS是默认且常用的选项,表示仅在当次分析所涉及的变量(即分组变量和检验变量)上存在缺失值时,才排除该个案。
案例(6-1):在99%置信水平下,判断中国男性和女性2015年总收入的总体均值是否相等?
请写出虚无假设、研究假设和检验过程
- H₀ (虚无假设):μ_男性 = μ_女性 (或 μ_男性 - μ_女性 = 0)。
- H₁ (研究假设):μ_男性 ≠ μ_女性。
方法一:在大样本(n ≥ 30)情况下,根据统计公式直接进行计算,包含三种方式 (理解内部原理)
- 第一种方法又可以通过三种方式判断
- 第一种方式:通过Z值判断(若Z值大于2.576,则拒绝原假设)
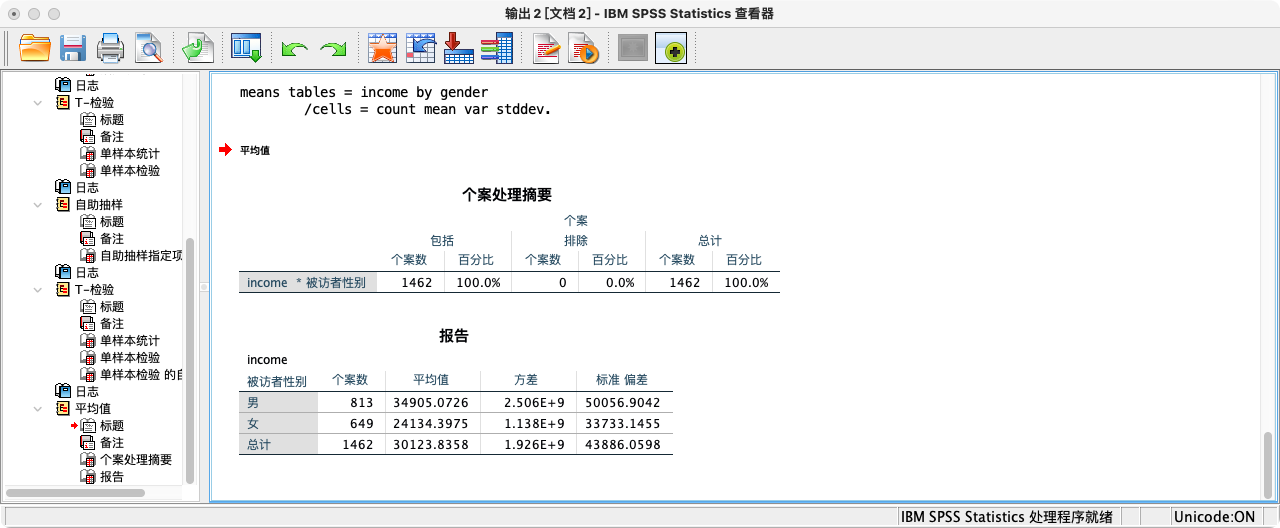
- 先查看男性样本和女性样本2015年总收入的个案数、均值、方差和标准差
| |
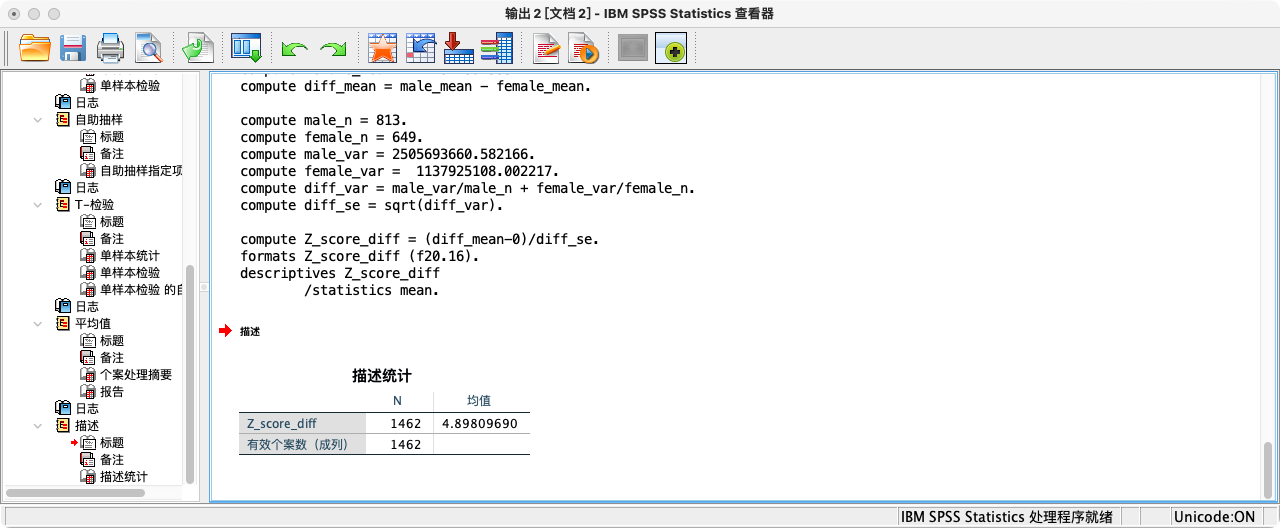
可知实际Z值(4.898096895558914)大于99%置信区间的Z值(2.576),拒绝虚无假设,接受研究假设
- 第二种方式:通过置信区间区间判断(若99%置信度下得到的区间估计值不包含0,则拒绝虚无假设)
- 这里第一、二步同第一种方式
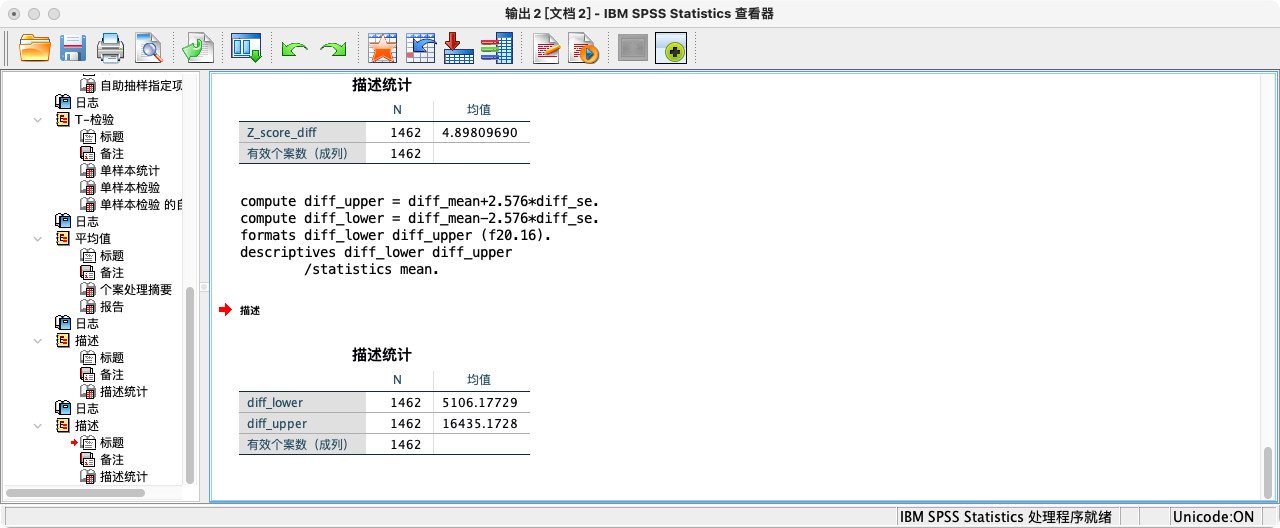
可知区间下限为5106.177290,不包含0,拒绝虚无假设,接受研究假设
- 第二种方式:通过p值判断(在99%置信区间下,p值若小于α即0.01,则拒绝虚无假设)
| |
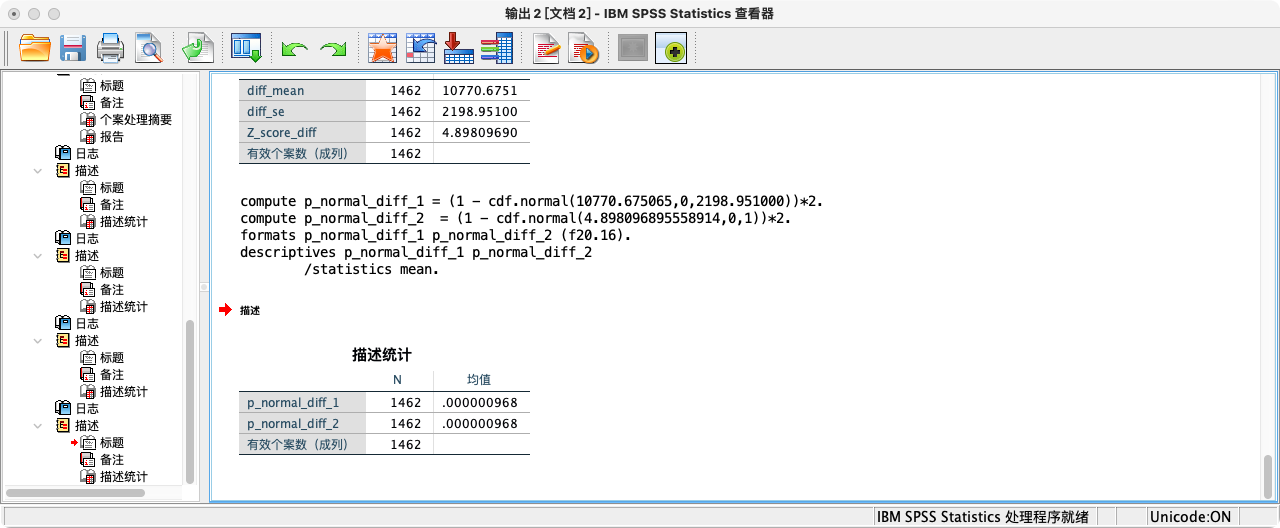
- 可知p值(=0.000000967693164)小于0.01,拒绝虚无假设,接受研究假设
若认为抽样分布为t分布,则假设检验须考虑两种情形
第一种情形:认为男性和女性2015年总收入具有相同的方差
- 由于每一种情形也具有三种判断方式,以下仅以p值为例
| |
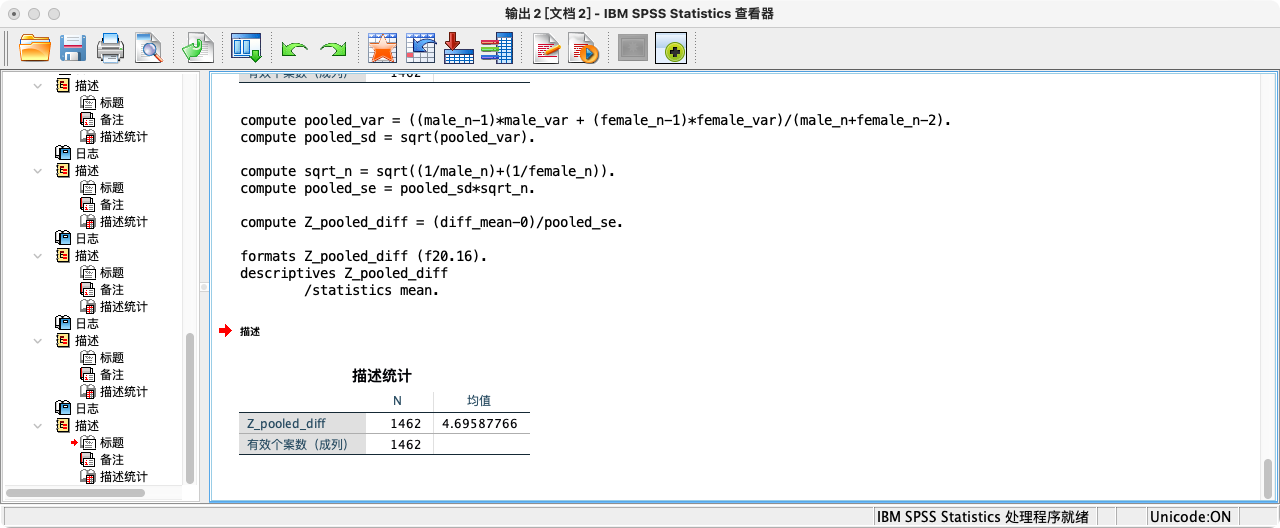
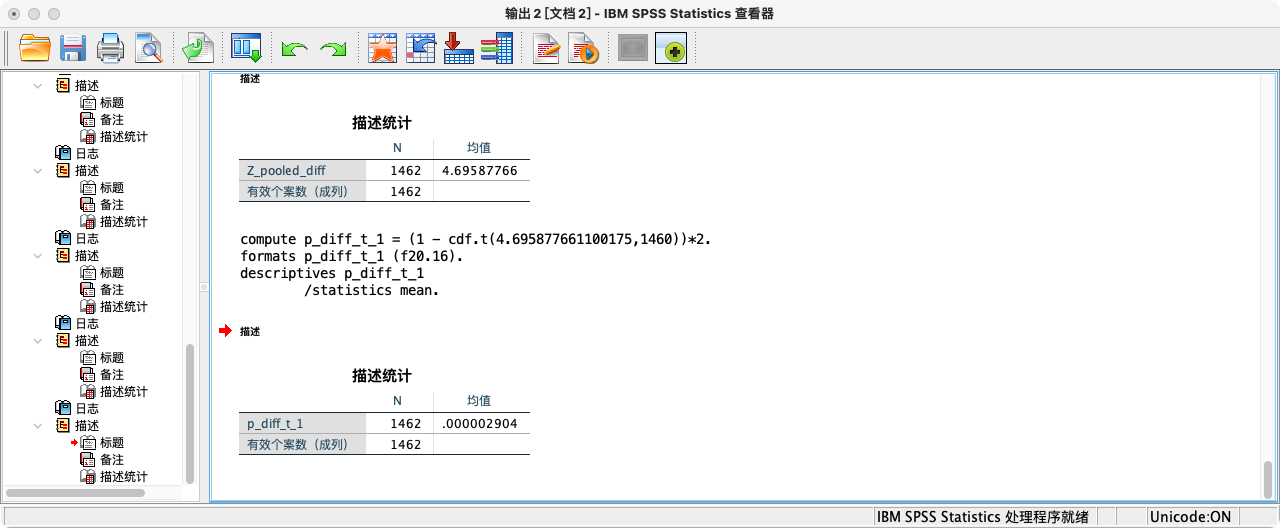
- 可知p值(=0.000002904076144)小于0.01,拒绝虚无假设,接受研究假设
第二种情形:认为男性和女性2015年总收入具有相同的方差
- 以下仅以p值为例
| |
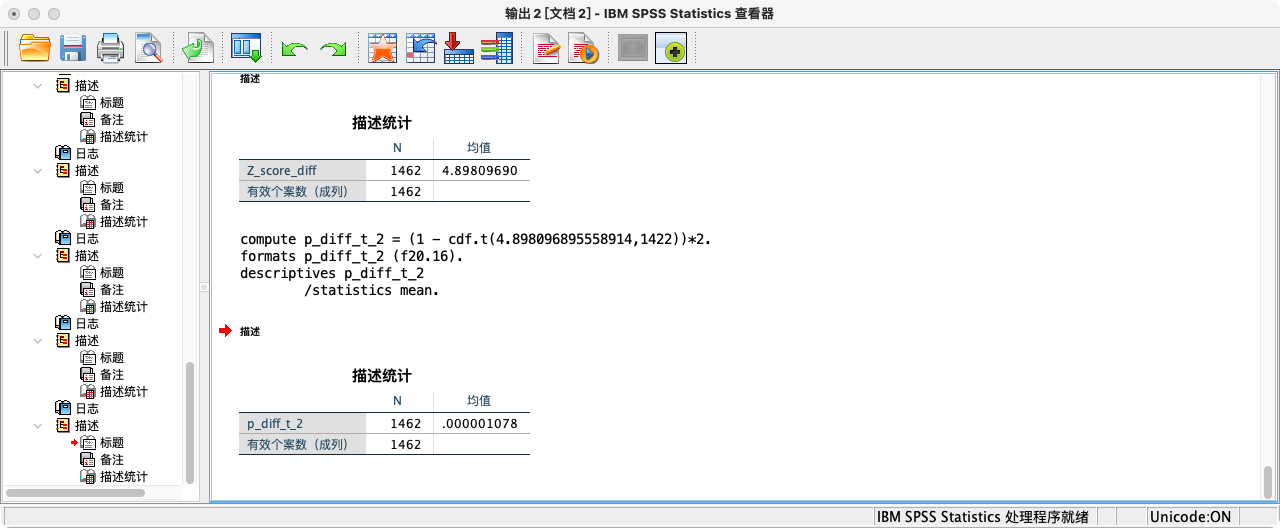
可知p值(=0.000001078383088)小于0.01,拒绝虚无假设,接受研究假设
方法二:使用
T-TEST命令 (标准流程)
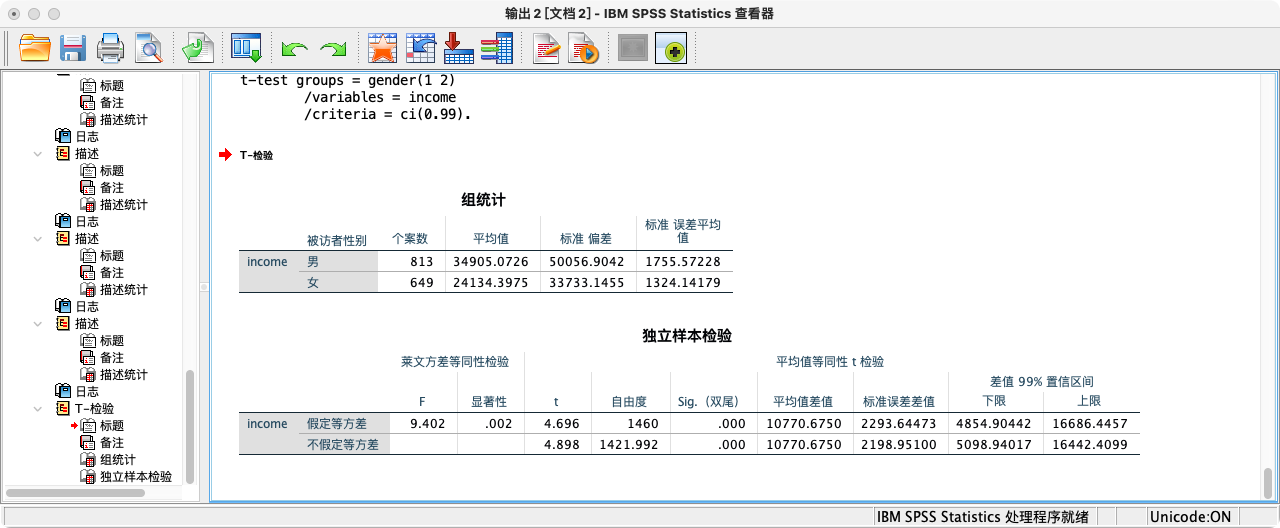
- 方法三:采用拔靴法(从已有样本不断重复抽取1400个样本,包含男性和女性)修正抽样分布标准误后,再进行假设检验
- 注意: 独立样本总体均值检验的拔靴法需要增加
INPUT,即分组变量
- 注意: 独立样本总体均值检验的拔靴法需要增加
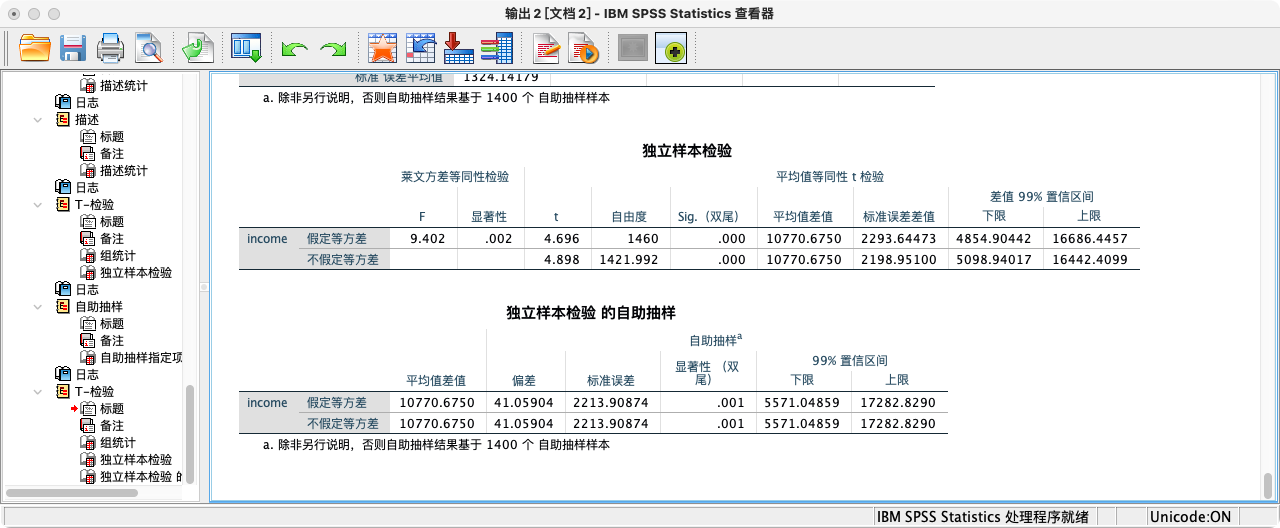
- 可知p值(=0.000714)小于0.01,拒绝虚无假设,接受研究假设.
随堂练习:试检验2015年中国男性和女性的总体平均最高教育程度是否相等,置信区间为95%.
7. 使用摘要信息进行T检验
- 使用场景:当我们没有原始数据,但从文献或报告中得知了两组的均值、标准差和样本量时,依然可以进行独立样本T检验。
- 点选操作:分析 → 比较平均值 → 摘要独立样本T检验 → 分别填入样本1和样本2的个案数、均值、标准差及标签 → 确定
- 语法操作:
| |
语法说明
SPSSINC SUMMARY TTEST- 这是命令的起始标志。
N1, MEAN1, SD1, LABEL1- 用于定义第一个样本组的摘要信息。
N1: 组1的个案数 (Sample Size)。MEAN1: 组1的均值 (Mean)。SD1: 组1的标准差 (Standard Deviation)。LABEL1: (可选) 为组1指定一个标签(字符串),用于在输出结果中清晰地标识该组。
N2, MEAN2, SD2, LABEL2- 用于定义第二个样本组的摘要信息,参数含义同上。
/OPTIONS CI=<置信水平>- 用于设定检验的标准。
CI: 指定置信区间的水平。注意,这里的数值是百分比,例如95或99,而不是小数。
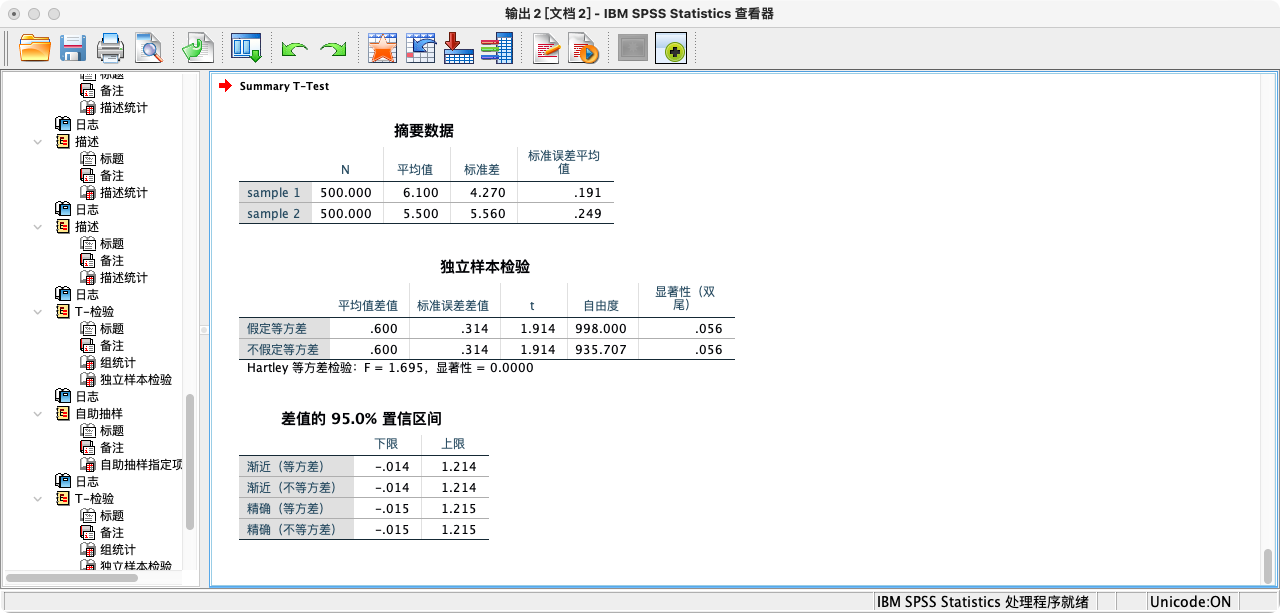
案例(7-1):若样本1个数为500,均值为6.1,标准差为4.27,样本2个案数为500,均值为5.5,标准差为5.56。
- 在95%置信度下,判断两者总体均值是否相等。请写出虚无假设、研究假设和检验过程
| |