【历史记录备份】面板数据分析与固定效应模型
Applied Panel Data Analysis Using Stata
Josef Brüderl & Volker Ludwig
- 面板数据导论
- 三类纵贯数据
- 横截面数据
- 面板数据
- 事件史数据
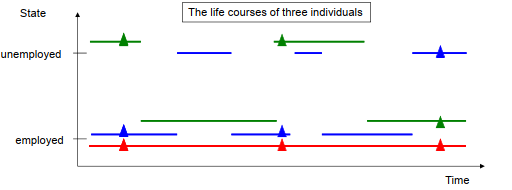
- 面板数据的来源
- 同一单元相同变量的重复测量
- 宏观面板:CSTS(cross sectional time series),小N大T
- 微观面板:Micro panel data,大N小T
- 面板数据的格式:每行均为“person-year(pyr)”
- 面板数据的两大优势
- 面板数据相比横截面数据允许在弱预设下识别因果关系
- 可以知晓事件(政策)的时间顺序(time-ordering of events)
- 可以调查一个事件(政策)何以改变结果
- 面板数据允许研究个人轨迹
- 个体增长曲线,如工资、物资、智力
- 可以区分世代和年龄效应
- 状态的转入转出,如贫困
- 面板数据的资料收集
- 截面调查:回溯性问题,如回忆性问题和事件历史资料
- 面板调查:当前状态的面板数据、事件史数据(电子生命史日历 electronic life-history calendar)
- 面板数据可能存在的方法论问题
- 面板条件作用(panel conditioning,或panel effect)
- 面板死亡(panel mortality,panel attrition)
- 重要的面板调查类型
- 家户面板调查(household panels),如PSID
- 同龄群面板调查(cohort panels),如NLSY79
- 在线面板调查
- 面板数据的基本思想
- 截面研究设计(cross-sectional research design)或组间估计(between estimation)
- 通过比较同一时间点的处理组和比较组的结果差异
- 面板研究设计(panel research design)或组内估计(within estimation)
- 通过比较相同的人群随时间变化而从控制组变为处理组的过程
- 组间估计与组内估计的差异
- 真正因果效应是基于个体层次的,但存在因果推断的基本问题,无法推估
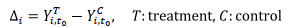
- 在截面研究设计中,可以进行组间推估
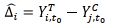
- 比较个体i和个体j在时间点t0的差异
- 基本预设是单元同质性(unit homogeneity)或无不可观测的异质性(no unobserved heterogeneity)
- 适合于实验数据,因为随机化单元变化来源于干预(randomization units will differ only in the treatment)
- 不适用于非随机数据,因为单元同质性预设被违反
- 自选择进入处理组(self-selection into treatment)
- 不可观测的单元异质性将会导致估计结果偏误
- 在面板研究设计第一种估计:组内推估
- 比较个体i在时间点t0和时间点t1的差异
- 基本预设是时间同质性(temporal homogeneity),或无时期效应(no period effect)、无成熟(no maturation)
- 在面板研究设计第二种估计:利用控制组进行组内推估,即within estimation with control group
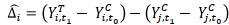
- 基本预设是平行趋势预设(parallel trends)
- 不可观测的单元异质性不会造成偏误,仅有处理组和控制组的不同时间趋势会造成偏误
- 时间同质性和平行趋势预设的差异
- 时间同质性预设:对于所有个体i,只有干预引起的结果在不同时期发生变化
- 平行趋势预设:对于干预组个体i,除了干预引起的结果在不同时期发生变化,其余因素引起的结果在不同时期发生变化的情况与控制组保持一致
- 双重差分方法的基本思想
- 利用控制组组进行组内估计,是所有组内估计量的基石
- within estimation with control group is the basic building block of any within estimator
- 线性面板分析的直观理解
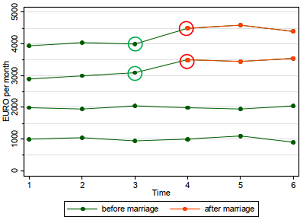
- 男性的婚姻溢价案例
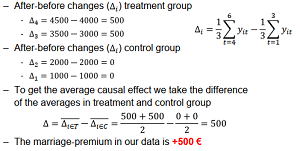
- 双重差分方法:
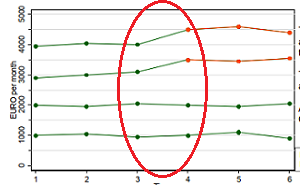
- 男性的婚姻溢价为500
- 在横截面研究设计(时间点4)中:
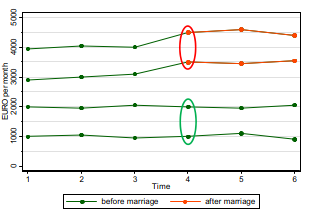
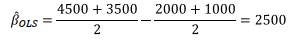
- 截面回归的结果:截面处理组平均值-截面控制组平均值
- 截面回归分析要求外生性预设(exogeneity assumption):


- 非实验数据中,自变量/干预是内生的,内生来自于不可观测的混淆变量(unobserved confounders)
- 通常被成为不可观测异质性(unobserved heterogeneity)或遗漏变量偏误(omitted variable bias)
- 混合所有期的数据也无法解决
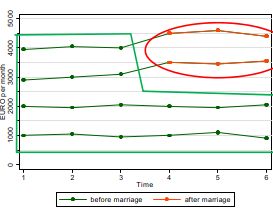
- POLS回归本质上依然是组间比较:跨期处理组平均值-跨期控制组平均值
- 面板数据本身并不能自动识别因果关系,面板数据要求研究设计能够充分发挥其优势
- 利用面板数据优势
- 误差分解(error decomposition)
- 面板数据必须结合组内估计(within estimation),即前后比较(after-before comparison)
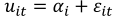
 :个人不随时间变化的误差项(person-specific time-constant error term)
- 预设:个人随机变量(person-specific random variable)
 :随时间变化的误差项(time-varying error term)或异质性误差项(idiosyncratic error term)
- 预设:零均值、同方差、无自相关
- 构造误差成份模型(error components model):
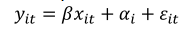
- 只有当自变量与两类误差成份无关时,POLS回归才可以得到无偏估计
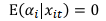 :随机效应预设(random-effects assumption)
- 不存在个体层面时间恒定的不可观测异质性(no person-specific time-constant unobserved heterogeneity)
 :同时期外生性预设(contemporaneous exogeneity assumption)
- 不存在随时间改变的不可观测异质性(no time-varying unobserved heterogeneity)
- 一阶差分估计量(first-differences estimator,FD):排除随机效应预设(预设过强,即认为个体恒定同质)
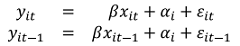
- 差分后得到
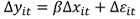
- 个体层面误差项(时间恒定异质性)已经被差分掉(differenced out)
- 一阶差分的问题
- 一阶差分要想得到无偏估计量,还需序列外生性预设(sequential exogeneity assumption),即要求不存在随时间变化的不可观测异质性
- 当期数超过两期时,一阶差分效率较低
- 一阶差分用到的信息量较少:只使用自变量存在时间变化的点
- 固定效应回归模型
- 误差成份模型:
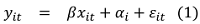
- 个体均值模型(称为组间回归between regression,BE):
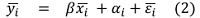
 :
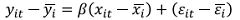
- 个体时间恒定的不可观测异质性已经被移除,剩下组内变异,此时POLS应用于去均值数据可得到固定效应估计量
- FE要求严格外生性预设:
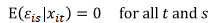
- 即
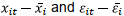 不相关
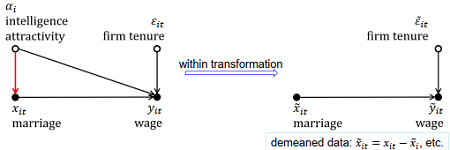
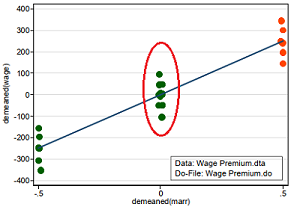
- 从散点图可知,从不结婚的群体对固定效应回归没有任何贡献(尽管Stata报告全部样本量,但并非全部样本量参与估计固定效应回归)
- 自变量没有变化的个体,其散点没有对斜率产生任何贡献
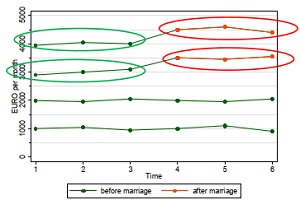
- 固定效应的解释
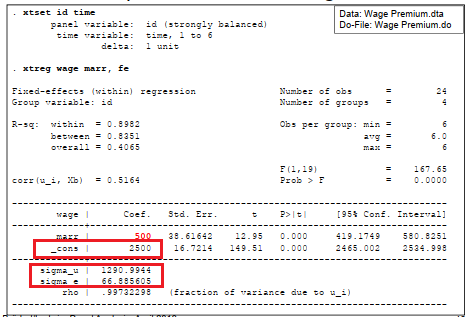
- 截距项=2500,表明所有组别的初始平均收入为2500(=[4000+3000+2000+1000]/4)
- 不随时间变化的异质性α_i=sigma_u
- 随时间变化的异质性ε_i=sigma_e
- 固定效应回归模型的变体
- 最小二乘虚拟变量估计量(least-squares-dummy-variables-estimator,LSDV)
- 个体斜率模型(Individual Slope Regression)
- 对所有处理组样本进行分开回归,然后对所有个体斜率做加权平均
- 如果处理组和控制组都存在随时间变化的趋势
- 对时间趋势建模:以年龄趋势为例子
- 固定效应回归与年龄-时期效应
- 固定效应回归预设时间同质性(temporal homogeneity),需要控制年龄效应(最好是年龄虚拟变量)
- 尽管模型不需要控制组,但删除控制组是无效率的,因为还需要利用控制组估计年龄和时期效应(period effect)
- 控制组对于估计时间趋势效应至关重要
- 倾斜趋势说明有年龄趋势,倾斜趋势的波折说明有时期趋势
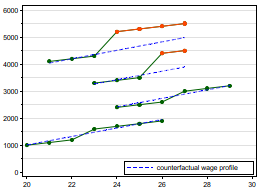
- 总而言之,同时控制年龄和时期效应,但同时控制两者虚拟变量存在APC问题
- 折衷办法是控制年龄虚拟变量和若干重点挑选的时期虚拟变量(selected period effects)
- 当时间趋势存在非线性(二次项)关系时,双向固定效应(个体固定效应+时期固定效应)仍然导致偏误
- 线性面板回归(linear panel regression)的基础
- 多元回归的外生性预设
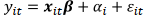
- 外生性预设(确保估计的有效性和一致性)
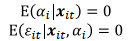
- 所有的误差项与自变量相互独立
- 弱一些的外生性预设(确保估计的一致性)
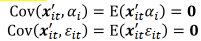
- POLS估计
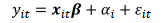
- 在非实验数据研究中,关于误差项外生性预设为:

- 随机效应预设
- 随机效应预设很容易违反,因为缓慢变化、难以测量的特征无处不在,如认知能力与非认知能力
- 同时期外生性假设(contemporaneous exogeneity assumption)
- 要求异质性误差项与自变量无系统性相关
- 固定效应模型估计
- 在去均值数据(demeaned data)中应用POLS估计
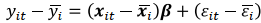
- 回顾固定效应模型所需预设
- 不再要求随机效应预设
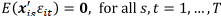 :严格外生性预设
- 任一时期异质性误差项与自变量不相关
- 去均值自变量矩阵的满秩(无多重共线性)
- 异质性误差项(Idiosyncratic errors)在不同时期有恒定的方差(同方差性)
- 异质性误差项是序列无关(无自相关性)
- 固定效应模型以外的组内估计模型
- LSDV:最小二乘虚拟变量回归
- 组作为虚拟变量
- 等同于固定效应模型
- 大N时无法计算
- first-differences:一阶差分模型
- 一阶差分估计
- 在差分数据中应用POLS估计
- 当T=2时,一阶差分模型与固定效应模型相等
- 当T>2时,一阶差分模型比固定效应模型没有效率
- (非平衡面板中,一阶差分模型比固定效应模型损失更多样本)
- 一阶差分模型要求序列外生性(sequential exogeneity):不存在随时间变化的不可观测异质性
- difference in differences:双重差分模型
- 双重差分模型的本质是带有控制组的前后比较设计(a before-after comparison with control group)
- 当T=2时,双重差分模型与一阶差分模型、固定效应模型相等
- 当T>2时,双重差分模型与一阶差分模型、固定效应模型不同
- 双重差分模型不推荐使用个体面板数据(individual panel data)
- 固定效应模型的统计处理
- 异质性误差项极有可能存在异方差和自相关性,忽略此将导致低估SE
- 解决办法一:预设更加符合现实的误差结构(error structure)
- xtgee:使用包含单元相关结构(unit-specific correlation structure)的广义线性模型
- xtregar:使用包含一阶自回归误差项(first-order autoregressive error term)的面板回归
- 缺点是高度依赖预设
- 解决办法二:面板稳健SE
- 使用Huber-White sandwich estimator,如vce(cluster id)
- 如果是有限样本,依然是有偏的SE
- 使用非实验数据分析的主要任务是使效应估计正确,其次才是SE
- 解决办法三:bootstrap SE
- 有放回地重估抽样估计50次
- 随机效应估计
- 误差成份模型:
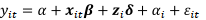
- 认为
 是独立同分布的随机效应(i.i.d. random-effects),通常是预设正态分布
- 同时需要两项前提预设
- 无时间恒定不可观测异质性,即随机效应预设

- 无时间变化不可观测异质性,即严格外生性预设
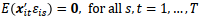
- 混合可行广义最小二乘估计(pooled feasible generalized least squares estimator, FGLS estimator)可以得到一致有效估计
- POLS可以得到一致但并非有效估计,因为自相关误差项(
 )
- 随机效应模型估计
- 在准去均值数据(quasi-demeaned data)中应用POLS估计
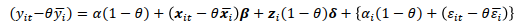
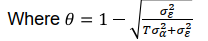
- 当θ=1,随机效应估计变成固定效应估计
- 在长面板(T很大)的数据中,随机效应模型与固定效应模型的估计值相近
- 当θ=0,随机效应估计变成POLS估计
- POLS模型、一阶差分模型、固定效应模型、随机效应模型之间的比较
- POLS是对原始面板数据进行OLS估计
- 一阶差分模型是对差分数据进行POLS估计
- 固定效应模型是对时间去均值(time-demeaned)数据进行POLS估计
- 随机效应模型是对部分时间去均值(partially time-demeaned)数据进行POLS估计
- 随机效应通常难以成功预测真实因果效应,因为随机效应预设被违反
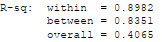
- 男性婚姻溢价案例偏误很小,因为
 很大,达到0.96
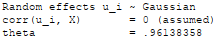
- 90%的工资变异性由婚姻状态的改变解释
- 线性面板分析的基础
- 面板数据的优势
- 面板数据允许在较弱的预设下识别因果关系:时间恒定的不可观测异质性不会导致估计偏误
- DID、固定效应模型和一阶差分可以在单元效应
 与解释变量相关的情况下获得无偏估计
- RE模型则会因为时间恒定不可观测异质性而有偏,但社会学使用比较普遍
- RE模型允许估计时间恒定的自变量系数
- RE在满足预设前提下,更有效(SE小)
- RE更有效是因为使用了变异间的内生性,但这种有效导致偏误
- 固定效应模型剔除时间恒定自变量并非缺点,而是优势,因为这个过程中已经把时间恒定不可观测的其他变量都剔除掉
- 把大量变量放进回归是kitchen-sink-approach (厨房水槽法)
- 如果需要估计时间恒定自变量,应采用组别增长曲线模型(group specific growth curves)
- 若非要用随机效应,则进行Hausman Test
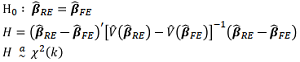
- 如果不能拒绝H0,说明随机效应估计与固定效应估计无显著差异
- 描述面板数据
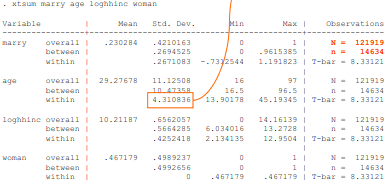
- 利用xtsum+vars,可以事先了解某个变量在个体内随时间变化的情况,即个体内时间变异性是否足够
- 图形化呈现回归结果
- 平均边际效应(average marginal effects,AME)
- 平均边际效应即连续型自变量的线性回归系数
- 预测值(predicted values)
- Z取值上X的平均边际效应,即条件效应(conditional effect)
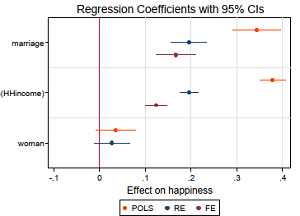
- 解释回归系数
- 描述性解释:人们若在X上有所差异,在Y上则有差异
- 已婚男性比未婚男性多挣2500美元
- 男性婚后比婚前多挣2500美元
- 因果性解释:X上的变化导致Y上的变化
- 婚姻导致男性收入溢价为500美元
- 描述性解释总时对的,因果性解释需要模型满足外生性预设
- 期望效应(anticipation effect)
- 如果人们期望某件事情一定会发生,我们将观测到事件发生前已存在的因果效应
- 期望效应也是对照组的一部分,固定效应会出现偏误
- 补救:利用事件发生前各个时点的虚拟变量
- 期望效应将捕获(可以应用于男性婚姻溢价研究)
- 遗漏变量
- 增长的选择性(处理组的陡峭增长)
- 反向因果性(在干预之前出现结果的改变)
- 难以识别期望效应还是干预的因果效应
- 通过滞后期时间虚拟变量难以刻画“真实的”期望效应,除非有强烈的理论理由!
- 交互效应(interaction effect)
- 尽管固定效应模型无法估计时间恒定组效应,但其与时变变量(干预变量)的交互效应可以估计
- 若交互项由两个时变变量构成,即便违反随机效应预设,固定效应模型依然可以得到无偏估计量
- 交互项具有对称性,可以自行决定何为干预组,何为调节组
- 连续生命历程事件效应
- 当作为干预的事件状态具有多个类别,组内估计进行比较时是基于同一参照组
- 如:单身、谈恋爱和已婚对收入的影响,预设单身->谈恋爱->已婚
- 恋爱效应:谈恋爱与单身比较
- 婚姻效应:已婚与单身比较
- 问题1:婚姻效应可能为无效因果效应,因为没有不经过恋爱的结婚
- 问题2:不能直接得到已婚与谈恋爱的比较。
- 应对策略:分组估计,如单身-恋爱组、恋爱-已婚组
- 对个体增长建模
- 结果变量随年龄和世代的发展:
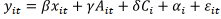
- 增长曲线建模较为弹性,包括线性、非线性、年龄虚拟变量、样条(splines)
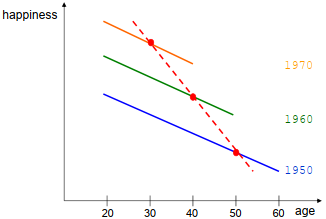
- 截面数据无法分离年龄和世代效应
- 截面数据即只有红点的数据
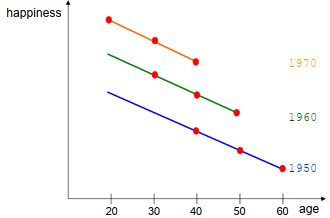
- 面板数据可以分离年龄和世代效应
- 用POLS模型刻画年龄曲线存在三大问题
- 混淆变量偏误
- 世代效应
- 时期效应、方法效应
- 构成效应(composition effects):妇女、东德、外国人
- 内生选择偏误:如受到不同死亡率和样本损耗的影响
- 最好的做法是估计FE增长曲线模型
- 过度控制偏误
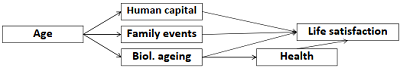
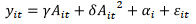
- 基于组的增长曲线模型(group specific growth curves)
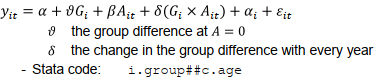
- 基于组的增长曲线模型对时间恒定变量提供更多信息
- 固定效应增长曲线模型
- 基于组的增长曲线模型无法采用固定效应进行估计
- 因为组别是非时变变量时,该组别的主效应无法被估计
- 混合模型(bybrid model)虽然提供主效应,但这是组间估计值,组内估计值仍然无法得到
- 随机效应增长曲线模型(RE-GCs)
- 在长面板情况下,随机效应增长曲线模型与固定效应增长曲线模型接近
- 随机效应增长曲线模型的组效应可能受到不可观测异质性的影响
- 模型设置
- 年龄应当对中
- 使用profile plot和conditional effect plot
- 基于组的增长模型经常用于纯粹的描述统计
- 进阶线性面板分析:替代性组内估计量(alternative within estimators)
- LSDV:使用areg
- 个体虚拟变量不会直接估计,但会被吸收
- R2的解释包括个体虚拟变量在内
- areg的SE大于xtreg的SE
- areg支持加权
- 个体斜率回归模型
- 固定效应模型是对所有个体回归模型斜率的加权平均(weighted average)
- 双重差分法
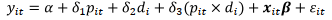
- α是控制组干预前的结果均值
- δ1是控制组结果均值在干预后的变化
- δ2是处理组均值在干预前的差异
- δ3是处理组均值在干预后的差异
- DID可以用于伪面板数据(在不同截面中根据组别计算均值,以组均值为个体,在多期数据中形成面板结构)
- 个体面板数据的DID时常无意义
- 无控制的DID等同于固定效应
- 有控制的DID将产生不真实结果
- 非政策干预的DID不直观,因为干预不在同一时点出现
- 控制组缺乏清晰的前后比较。
- 有学者尝试使用PSM-DID构造控制组
- 固定效应个体斜率回归模型(the fixed effects individual slopes model)
- 平行趋势预设
- 在严格外生性预设下,处理组与控制组的潜在结果平行
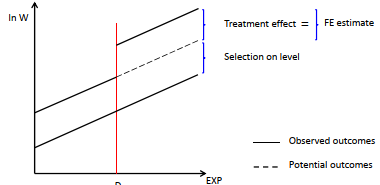
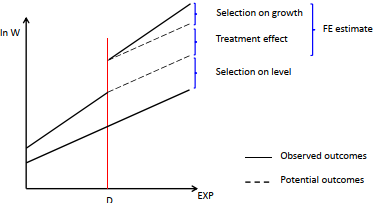
- 平行趋势违反:异质性增长
- 原因是存在不可观测的时变变量
- 异质性增长也会使FE估计量有偏的(选择性增长,selection on growth)
- 采用固定效应个体斜率模型(FEIS model)
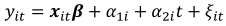
- 这种模型是固定效应+个体截距和斜率
 刻画结果变量增长的个体异质性
 刻画不可观测时变异质性(即异质性增长 heterogeneous growth)
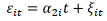 ,实际上后两者即是异质性误差项,因此我们通过模型排除
 的影响
- FEIS模型要求更弱的外生性预设
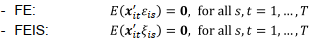
- 只要不可观测的个体异质性来自于个体增长趋势,偏误不再是问题
- 排除个体趋势的方法
- 包含个体水平和趋势虚拟变量的LSDV
- 二阶差分估计
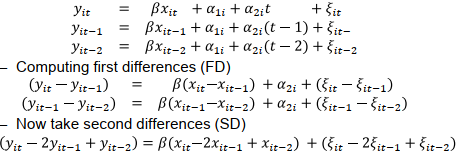
- 已经排除了α1i和α2的取值,此时使用POLS可以得到无偏估计
- 二阶差分需要至少3期数据,但T>3时较缺乏效率
- FEIS估计量
- 第一步:估计每个单元的个体增长曲线
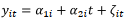
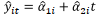
- 第二步:从个体实际结果取值中剔除预测趋势(detrended)

- 第三步:重复前两步,对处理变量去趋势

- 第四步:混合去趋势的数据,执行POLS回归
- FEIS估计量的原理是排除趋势,剩余非趋势的变异性,使得异质性增长趋势不再造成估计偏误
- 这个过程可以普遍化(generalized)
- 更高阶的趋势也可以建模
- 非时间变量的个体斜率也可近似处理
- 有现成命令:xtfeis
- 广义FEIS模型
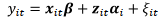
 表示个体斜率的1×j个变量
- 去趋势需要至少j+1个观测值
- 去趋势模型为
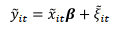
- 去趋势后,
 被剔除
- 广义FEIS模型需要更弱的预设
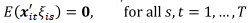
- 即异质性误差在控制个体斜率情况下与自变量(干预)无关
- 广义FEIS模型是否导致过度控制?
- 如果FEIS不能分离趋势与干预效应,FEIS将导致干预的有偏估计
- FEIS常用于宏观面板
- 与LSDV相似,FEIS通常使用POLS估计
- 混合系数面板模型(mixed-coefficient panel data)
- 面板数据是一种特殊的多层次数据
- 最低层次是person-year,person-year嵌入到第二层persons
- 多层次模型(层次线性模型)完全可以应用于面板数据
- 混合系数模型在Stata中被称为“混合效应模型(mixed-effects models)”
- 系数具有固定取值:固定效应
- 系数具有随机取值:随机效应
- 以上与固定系数、随机系数及混合系数模型等同
- 随机系数模型可被认为是
- 随机效应:外生随机变量服从正态分布
- 固定效应:潜在内生随机变量已被差分
- 在多层次传统中,随机系数被认为是随机效应
- 基本模型设置
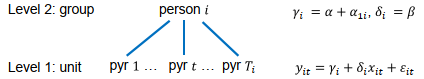
- 层次一允许个体系数:

- 层次二变化为随机截距(random intercept model)
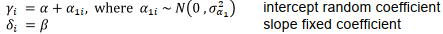
- 因此有:
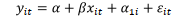
- 等同于随机效应模型,
 为随机效应
- 层次二变化为随机斜率(random slope)

- 因此有:
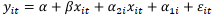
- 随机斜率模型
- 基本模型:
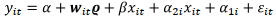
- 模型预设:
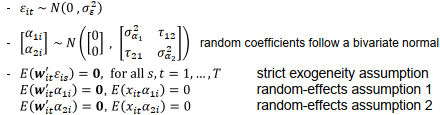
- 强外生性预设:
- 无个体时间恒定不可观测异质性(随机效应预设)
- 个体斜率与自变量不相关(随机效应预设)
- 严格外生性预设稍弱一些,因为
 已剥离

- 随机效应/随机截距、固定效应、随机斜率、固定效应个体斜率模型比较
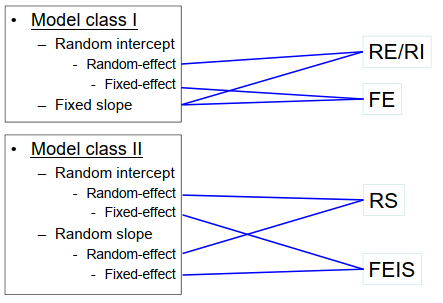
- 随机斜率模型与固定效应个体斜率模型比较
- 随机斜率:随机系数被预设为随机效应
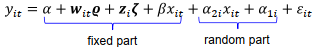
- 固定效应个体斜率模型:随机系数被预设为固定效应
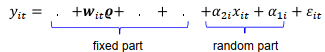
- 两类模型预设
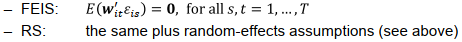
- 解释随机斜率模型
- 年龄随机斜率:
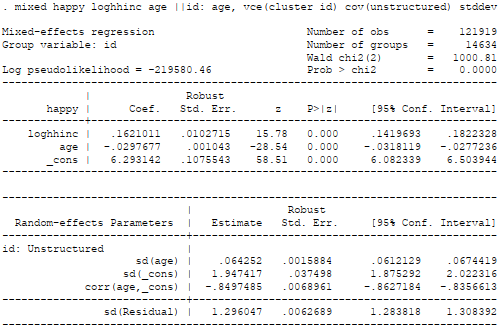
- 年龄固定斜率为-0.030,95%置信区间下个体斜率均值为
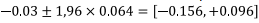
- 随机截距与斜率的相关性为-0.85,表示斜率越高,截距越低
- 基于组的增长曲线模型可以用混合系数模型来表示
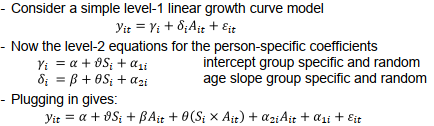
- 这是随机斜率模型+指定性别组增长曲线
- 当
 ,此为随机效应增长曲线模型
 是跨层交互项
- 这也是一种简单形式的潜在增长曲线模型(latent growth curve model,LGCM)
- 随机斜率模型的应用
- Raudenbush强烈推崇RS-GS模型
- RS-GC模型可以描述个体增长轨迹差异,当其不存在自选择偏误时
- 如果想得到因果效应,建议FE/FEIS模型
- 如果随机效应预设违背,RS模型是有偏
- 混合模型(Hybrid Model)
- 混合模型是为了弥补固定效应模型无法估计时间恒定变量的系数(被差分掉)
- 混合模型由Allison(2009)提出,并被Schunck(2013)系统阐释
- 混合模型是随机效应模型+分解变量
- 将时变预测变量分解为两部分
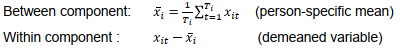
- 两者合二为一
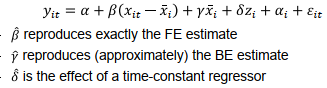
- 混合模型等价于Mundlak Model
- Mundlak模型:
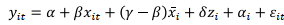
- 优势在于保留未转换的
 ,只需再添加一个变量
- 劣势在于
 的系数是组内与组间效应之差,不可解释
- 检验β=γ即等同于随机效应与固定效应的Hausman Test
- 优势在于可以仅检验单个参数值
- 如果β=γ,则Hybrid Model变成随机效应模型
- 解释混合模型
- 成份内β系数估计量是FE估计量
- 成份间γ系数估计量是纯粹的组间估计量(BE),净化自组间成份,但实质上无意义
- 时间恒定变量的δ系数是同时控制组间和组内成份
- 如果对时间恒定效应感兴趣,最好用基于组的增长曲线模型
- 混合随机斜率模型
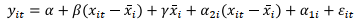
 属于固定效应估计,并且是带有异质性效应的固定效应模型
 是平均因果效应估计量
 估计平均效应的方差
- 预设
- 不再需要:无个体时间恒定不可观测异质性
- 严格外生性预设仍需要
- 自变量与不可观测随机斜率不相关:

- 混合模型是面板分析标配吗?
- 混合模型优势
- 提供组间效应
- 但很多效应无实质意义
- 提供时间恒定自变量系数估计
- 但还不如随机效应增长曲线模型提供信息多
- 提供跨层次交互项
- 很难准确估计
- 允许异质性因果效应
- 但用处不大
- 允许超过两层
- 混合模型相比固定效应,过于复杂
- 面板数据的缺失值处理
- 面板数据的缺失数据来源
- 第一轮的单元无反应
- 轮次内的缺失性(within-wave missingness,即数据gap)
- 项目无反应
- 并非每一轮数据都有相同题组
- 整轮缺失性(whole-wave missingness)
- 临时单元无反应(数据gap)
- 永久单元无反应(面板损耗)
- 无反映将导致回归估计偏误
- 如果只有可观测变量影响响应率,属于随机缺失(MAR)
- 处理办法是控制相应变量
- 如果干预与结果同时影响响应率,属于非随机缺失(NMAR)
- 内生选择偏误(endogenous selection bias)
- 应对非随机缺失
- 选择模型
- 加权(由第一轮无响应+面板损耗计算得到)
- 多重插补(针对数据gap而非损耗)
- 面板数据加权
- 加权的本质:使得未被充分代表的单元(underrepresented)获得更多权重
- 权重类型
- 截面权重(cross-sectional weights,CW)
- 调整面板样本至推估总体(事后分层权重)
- 可以补充第一轮的单元无响应
- 可以为后续轮次而建构
- 长期权重(longitudinal weights,LW)
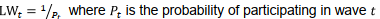
- pt是根据logit模型估计,因变量是第t期响应率,自变量是t-1期的自变量
- 可以补偿永久性的单元无响应
- 追踪权重(panel weight,PW)
- 对pyrs加权
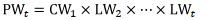
- 如果存在gap,LW=1
- 非线性面板分析
- 事件史分析
- 组内分析方法的局限
- 最后的思考