追踪数据的损耗偏误调整 | Stata
Kocar, S. (2020). Attrition. In P. Atkinson, S. Delamont, A. Cernat, J.W. Sakshaug, & R.A. Williams (Eds.), SAGE Research Methods Foundations. https://www.doi.org/10.4135/9781526421036926973
- 损耗(attrition)
- 指研究中的数据丢失(loss),又称为数据损耗(data attrition)
- 主要出现在纵观研究、队列研究和面板研究中,又称为面板损耗(penal attrition)
- 包括单位无响应(unit-nonresponse)和项目无响应(item-nonresponse)
- 在纵观调查中,面板损耗主要是单位无响应,而且通常是永久性无响应
- 被调查者退出研究
- 难以追踪到:流动人口
- 由于疾病或死亡无法继续参与调查
- 减少损耗的办法
- 提供奖励
- 面板管理:与跟踪样本成员保持联系
- 优化调查设计、问卷设计和数据收集频率
- 损耗带来的问题
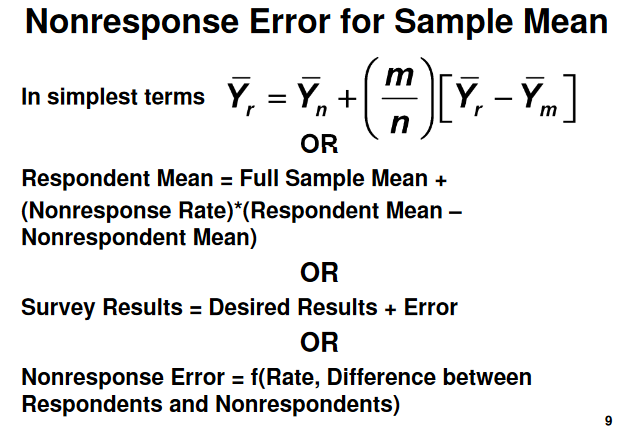
- 导致样本量的累积减少,导致统计检定力下降,进而导致损耗偏误(attrition bias)
- 损耗偏误可能与人口学、社会经济学、心理学、态度、行为或者其他特征相关联
- 随机损耗只会降低样本的效率(efficiency),非随机损耗会在估计中引入额外的偏误
- 量化评估样本损耗
- Peter Lynn(2005):面板调查的响应率
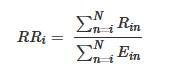
- RR是响应率,R是该轮调查中的单位响应,E是单位样本合格
- 条件响应率(conditional response rate)
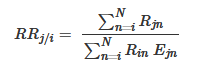
- Rjn是第j轮的单位响应,Rin是第i轮的单位响应,Ejn是第j轮的单位资格
- 损耗率为1-RR
- Charles DiSogra 和 Mario Callegaro (2016)提出计算面板设计的损耗率
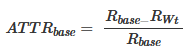
- Rbase是第1轮的响应者人数,Rwt是时点t的响应者人数,该公式可以计算第一轮和后续轮次之间的累积损耗率
- 连续损耗率则可计算为
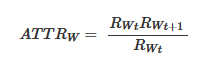
- Rwt是特定轮次中的响应人数,Rwt+1是下一轮次中的响应者人数。
- 样本损耗的事后调整
- 考虑单位退出概率的面板数据加权
- 为提高估计的准确度,要为加权模型选择正确的变量
- Vandecasteele, L., & Debels, A. (2007). Attrition in panel data: The effectiveness of weighting. European Sociological Review, 23(1), 81–97.
- Heckman两步法
- 计算损耗的发生概率,创建可以纠正偏差的系数 λ (Miller & Wright,1995)
- Miller, R. B., & Wright, D. W. (1995). Detecting and correcting attrition bias in longitudinal family research. Journal of Marriage and the Family, 57(4), 921–929.
Salkind, N. J. (2007). Attrition Bias, Encyclopedia of measurement and statistics (Vols. 1-0). Thousand Oaks, CA: Sage Publications, Inc. doi: 10.4135/9781412952644
- 损耗偏误
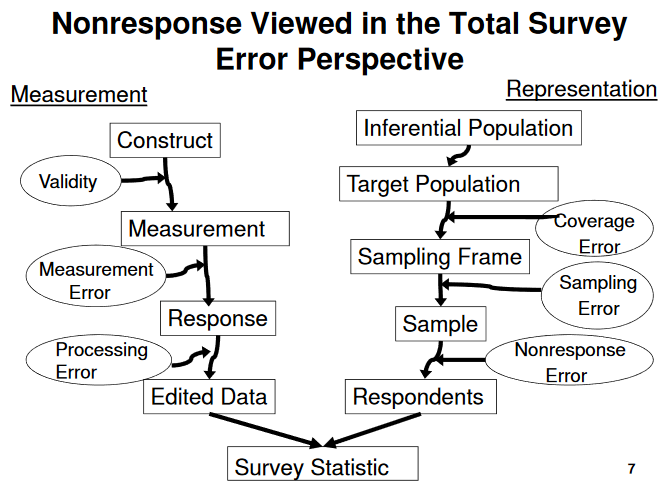
- 在追踪调查中,当退出研究的人与留在研究中的人有系统性差异,那么原始样本的损耗就是一种潜在的损耗偏误威胁
- 损耗偏误的两种造成研究偏误的方式
- 损耗偏误会影响研究的外部信度,如果某些群体频繁地退出研究,那么随后的纵向样本不再像研究中的原始样本,剩余的样本对于取样的原始总体是不可推广的
- 系统性损耗会改变原研究中变量之间的相关性,从而对研究的内部效度产生负面影响。当子样本以较高速率退出研究,在纵向样本中的代表性不足,可能导致变量之间的相关性不同于原始样本中的真实相关性
- 检测损耗偏差(detecting attrition bias)
- 过早退出研究中的人(droppers)和留在样本中的人(stayers)之间的差异可以通过logistic回归模型来评估
- 因为两组都参加了第一轮调查,第一轮数据信息可以构造自变量
- 人口学变量:种族、收入、年龄、教育程度
- 研究中的实质性变量:抑郁症、药物滥用或婚姻质量
- 因变量是是否在第二轮调查中损耗
- 损耗偏误对内部效度的威胁可以通过比较整个样本(overall sample)和追踪样本(longitudial sample)中第一轮的相关矩阵(correlation matrices)来测试
- 第一种方法
- 计算整个样本中年龄与抑郁症之间的相关系数
- 计算追踪样本中年龄与抑郁症之间的相关系数
- 用Fisher's Statistical Test来检验两个系数之间是否存在显著差异(损耗改变了变量之间的相关性)
- 第二种方法
- 构建结构方程模型,检验两个相关矩阵之间是否不相关
- 对损耗偏误的纠正(correcting attrition bias)
- 已知损耗机制时的数据纠正
- 建立一个同时计算研究问题和缺失数据机制的模型
- 第一个模型是解决研究问题的回归模型,通过对研究问题中的关键自变量和因变量进行回归
- 第二个模型是损耗模型,加入引起损耗的变量,因变量是第二轮损耗与否的二分类变量
- 两个模型中的误差项之间的显著相关表明存在损耗偏误
- 如果误差项相关性显著,则将第二个模型的自变量包含在内,为第一个实质性回归模型提供校正后的回归系数
- 不知损耗机制时的数据纠正
- 纠正方法是Heckman两步法
- 首先创建一个logistic模型来解释损耗的原因,自变量是可能引起损耗的因素,可以预测损耗
- 基于第一个模型创建一个结果变量 λ (lambda),它是一个损耗因素的代理变量
- 将每个参与者的λ值合并到数据集中,加入实质性研究问题的模型,可以修正损耗偏误,使回归系数更准确
- 虽然Heckman模型已经被研究者使用很多年,但有研究者对此方法可行度提出质疑
- Stolzenberg 和 Relles认为Heckman模型计算了不准确的估计结果,并且指出使用改模型时的注意事项
- Stolzenberg, R. M., & Relles, D. A. (1997). Tools for intuition about sample selection bias and its correction. American Sociological Review, 494-507.