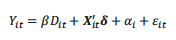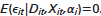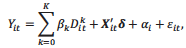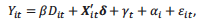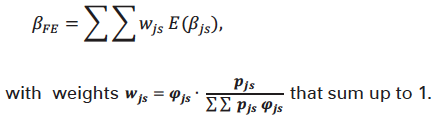利用面板数据估计影响函数|Stata

  • Ludwig, V., & Brüderl, J. (2021). What You Need to Know When Estimating Impact Functions with Panel Data for Demographic Research. Comparative Population Studies, 46.
  • 事件影响研究与影响函数
    • 研究特定事件对某些结果的因果效应,称为“事件影响(the effects of events)研究”(Allison,1994)
    • 横截面数据:所有影响干预和结果的非时变和时变混淆因素必须得到控制
    • 面板数据:利用个体内设计(within-person designs)控制非时变混淆因素,如固定效应模型
    • 在长面板数据中,许多个体观测值在接受干预后还存续超过一个时期,这时可以估计时变干预效应(time-varying treatment),即因果效应的时间路径(the time-path of a causal effect)或影响函数(impact function)
    • 影响函数的社会学洞察力:获得比估计非时变干预效应更多的东西,人口学一般采用固定效应模型
    • 利用面板数据和固定效应模型估计影响函数存在许多缺陷和偏误
  • 影响函数的基本概念
    • 影响函数研究的两方面重要性
      • 研究的实质性贡献:影响函数往往具备重要的理论意涵
        • 短暂效应(short-lived effect)、持久效应(persistent effect)抑或递增效应(increasing effect)
        • 短暂效应:心理适应理论(psychological adaptation)或跑步机(treadmill)理论
        • 持久效应:家庭专业化理论(household specialization)
      • 研究的方法论贡献:对于时变干预效应(time-varying treatment effects),不同统计模型具有不同结果
        • 固定效应模型和一阶差分模型:在估计非时变干预效应方面,无控制组情况下,可能提供相同结果;但估计时变干预效应方面,两者产生估计差异巨大
        • 非时变影响函数存在“负向加权偏误(negative weighting bias)”问题,通常发生在交错干预效应情况下(staggered treatment effect)
          • 这是固定效应估计量的机制导致的
          • 对于非时变影响函数,固定效应估计会在干预后很长一段时间内,由于受干预观测值乡下加权(down-weighting of treated observations)产生偏误
        • 人口学面板数据经常采用交错干预设计(staggered treatment designs):干预分配发生在不同时间点。处理该问题需要更灵活的影响函数
  • 影响函数估计的基本框架
    • 在严格外生性条件下,固定效应模型可以获得无偏和一致估计
      • 即使干预分配是非随机的,即有意识地选择或其他系统性模式,也可以进行因果干预效应估计
      • 严格外生性条件:,即时变误差项严格外生
      • 从基于设计(design-based)的视角来看,严格外生性假设意味着平行趋势假设(parallel treads assumptions)必须成立
    • 基于固定效应模型,建立影响函数有三种方式
    • 阶跃影响函数(step impact function)
      • 影响函数是个二分干预变量
      • 干预效应β是描述阶跃影响函数的单一参数:无论个体何时接受干预,该模型仅估计对结果的直接和永久性变化(immediate and permanent change)
    • 连续影响函数(continuous impact function)
      • 干预变量Kit包含干预分配后的时间
        • 技术上等同于Dit与干预后连续时间的交互变量
      • Kit系数表明干预后发生多少结果的变化,即随着时间单位的递进,结果发生多少额外变化
      • 连续影响函数可以采用多项式,以逼近更复杂的时间路径
      • 一般采用线性样条,以便放松函数形式的假设
    • 虚拟变量影响函数(dummy impact function)
      • 干预变量D^k_it表示一组虚拟变量,k=0表示干预后的第一个观测值,k=K表示最后一个
  • 案例:子女出生对母亲幸福感的影响
    • 第一次生育对女性幸福感的总体因果效应
      • SOEP,16-47岁,非平衡面板数据
      • 结果变量是幸福感(0-10分)
      • 混淆因素:年龄、同居关系、婚姻关系、主观健康、怀孕虚拟变量
      • 聚类稳健标准误
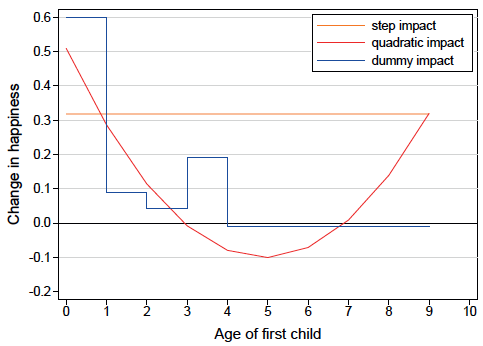
      • 影响函数:是否有子女(阶跃影响)、子女出生连续时间(二次项影响)、子女出生时间虚拟变量(虚拟变量影响)
    • 结果解读
      • 阶跃影响:子女出生使幸福感平均提高0.32分
      • 二次项影响:子女出生使幸福感提高0.51分,然后在第三年降到0以下,在第5年降到最低点,然后触底反弹
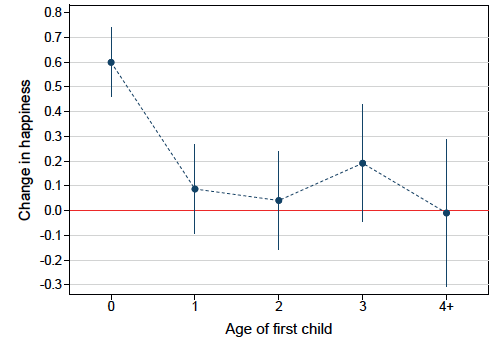
      • 虚拟变量影响:子女出生使幸福感提高0.60分,然而婴儿效应是非常短暂的,只存在于出生后的第一年。
      • 图1提供了负向加权偏差的图示,虚拟变量影响函数估计的10个干预效应的平均值=(0.60 + 0.09 + 0.04 + 0.19-0.01 * 6)/10 = 0.086,远低于阶跃函数0.32,说明阶跃函数严重高估了干预后的效应。
        • 固定效应估计的机制在后续干预后时期对干预效应有向下的加权(mechanics of FE estimation down-weights the treatment effects that occur in later post-treatment periods)
        • 阶跃影响的固定效应估计偏向于早期干预效应(biased towards the early treatment effects)
        • 注意:负向加权偏误(negative weighting bias)并不总是对干预效应产生负面的偏差,即向下的偏差或低估的偏差;“负向”值后续干预干预效应的减权(down-weighting of later treatment effects)
      • 虚拟变量影响函数的置信区间图表明:后续干预效应可能为0效应
  • 影响函数估计的陷阱及其补救措施
  • 陷阱1:结果轨迹的设定(specification of the outcome trajectory)
    • 模型设定必须包括年龄效应或周期效应,排除由于衰老和成熟导致的虚假干预效应或抑制真正效应
    • 共线性问题:难以区分日历时间(年龄)和干预后时间流逝的效应,这限制了Kit的虚拟变量数目。对此,应该在估计样本中加入从不接受干预的个体作为控制组,以便能够识别连续影响函数或虚拟影响函数
    • 年龄效应设定问题:一般而言,年龄作为线性项,但建议将年龄作为虚拟变量,应为结果的轨迹往往是高度非线性的。只有当得到的虚拟变量系数呈现规则化模式时,才应该选择更简洁的设定。
    • 时期效应设定问题:存在经济和政治周期的混淆因素,为了解决APC问题,可以把几年分成一组,或采用政治经济代理变量(GDP增长率)来刻画周期效应
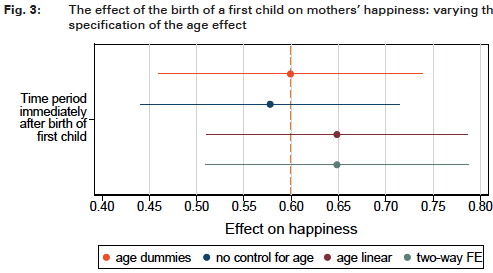
    • 双向固定效应问题:在大多数人口学研究中,年龄效应比时期效应更加重要。广泛使用的双向固定效应模型把时期效应的优先性置于年龄效应之前,缺少年龄控制。
      • 此时γt代表时期固定效应,Xit不包含年龄,时期效应将包含时期和年龄效应的混合结果
    • 生育与女性幸福感案例
      • 结果显示
        • 不控制年龄效应导致向下偏误
        • 年龄线性项可能产生过度控制偏差
        • 双向固定效应模型可能导致高估偏差
  • 陷阱2:干预前与干预后虚拟变量(pre-treatment and late post-treatment dummies)
    • 预期效应(anticipation effect)问题:干预前虚拟变量
      • 案例:期待子女出生本身,可能已经带来幸福感的提高
      • 在理论表明可能存在预期效应的案例中,不设定干预前因果变量,可能会把正向的预期效应错误地归因于参考起的生命历程效应中
      • 设定干预前虚拟变量要小心,不应盲目把干预前虚拟变量作为自变量
        • 混淆了别的效应:干预前虚拟变量可能是预期效应,也可能是其他效应。这是因为模型设定忽略了其他时变混淆因素,如家庭关系变化的预期效应混入子女出生的预期效应中
        • 反向因果:干预前的虚拟变量可能捕获逆向因果关系,特别是反馈效应(feedback effect)
          • 反馈效应:对生活满意度的期望导致人们决定生孩子
        • 对增长的选择:自我选择进入干预可能与结果的增长趋势有关
          • 一生都快乐的人最终可能会要小孩
      • 干预前虚拟变量的效果通常难以解释
    • 虚拟变量影响函数建模问题:干预后虚拟变量
      • 因为交错干预(staggered treatment),早期受到干预的个体在干预后很长一段时期仍然可以观测到
      • 由于面板损耗,通常只有很少的观测值具有后续干预后虚拟变量
      • 如果将某一时期以后干预后虚拟变量分组,统一设定为剩余虚拟变量(residual dummy),比如将生育后4年统一设为一组,可能导致干预效应偏差
        • 偏差在于:上限时间点之后作为一组,好比加入一个阶跃影响函数(导致负向加权偏差),那么若存在时变干预效应,负向加权偏差将导致剩余虚拟变量估计有偏
        • 由于偏误转移,所有的虚拟变量影响函数可能都是有偏的(Borusyak/Jaravel 2017)
      • 这种情况下,可以将4年以后数据截断并重新估计虚拟变量影响函数,作为稳健性检验
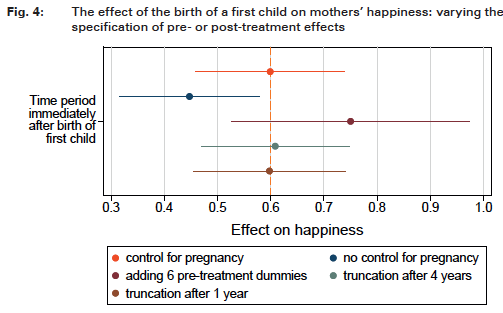
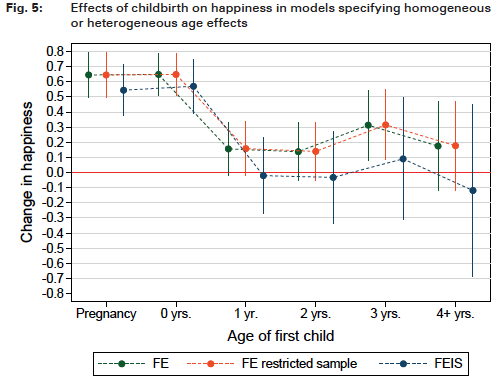
    • 案例:生育与幸福感
      • 模型1:控制怀孕,可能捕获部分预期效应
      • 模型2:不控制怀孕,可能导致低估
      • 模型3:加入6期干预前虚拟变量,可能捕获其他效应
      • 模型4和模型5采用截断数据,发现结果与模型1相似
  • 陷阱3:异质性轨迹导致的有偏影响函数(biased impact functions due to heterogeneous trajectories)
    • 异质性增长轨迹导致影响函数估计偏差,因此对影响函数建模时要允许异质性生命历程
    • 方法1:加入时间进程或年龄与非时变干预组指标的交互项,即特定组斜率固定效应模型(FE with group-specific slopes, FEGS)
    • 方法2:允许个体指定斜率轨迹,即个体特定斜率固定效应模型(FE with individual-specific slopes, FEIS)
      • 解决非时变混淆因素与干预组结果轨迹异质性的相关性
    • 对个体斜率建模可以放松平行趋势假设,扩展的豪斯曼检验可以判断固定效应模型是否有偏
    • 案例:生育与幸福感
      • 使用FEIS时,不能使用年龄虚拟变量而是年龄的线性项作为控制,以确保模型的节俭(parsimonious model),减少待估参数
      • 限制性样本:仅包括观测三期以上的个案
      • 扩展豪斯曼检验表明,受限样本固定效应模型与FEIS模型系数无显著差异
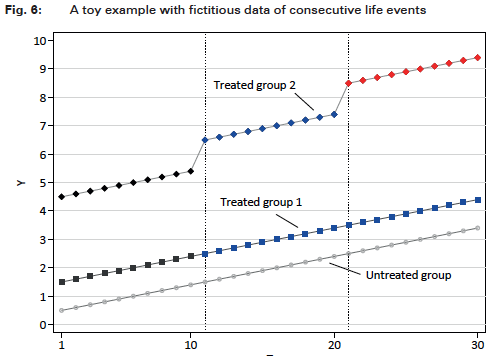
  • 陷阱4:连续性生命事件(consecutive life events)
    • 连续性生命时间具有异质性效应
      • 如:生第二胎子女的效应不同于生第一胎子女的效应
    • 单一估计样本策略(single estimation sample strategy):加入虚拟变量,表明胎次
      • 如果个体间生第一胎子女的效应也存在异质性,生第二胎子女效应取决于第一胎,则单一估计样本策略也存在问题
      • 比如,第一次生育获得更高回报的人,相比于没有回报的人,更愿意生第二胎
    • 区分不同干预效应的差异
      • E1:仅有一个小孩的女性与没有小孩的女性相比,生育的效应
      • E2:有1个小孩和2个小孩的女性与没有小孩的女性相比,生育的效应
      • E3:有2个小孩的女性与有1个小孩的女性相比,生育的效应
      • 单一估计策略认为E1和E2相等
      • 干预组1的干预效应为0,干预组2在第一次干预时效应为1,第二次干预时效应为1
    • 关于连续性生命事件(复杂生命历程事件)的估计策略
      • 关注具体的转变,并相应地构建估计样本
      • 不能从单一估计样本中估计所有的干预效应,而是专为多个专门定制的估计样本(specially tailored estimation samples)
      • 从比较潜在结果的基础上定义事件的因果效应,并构建适当的样本
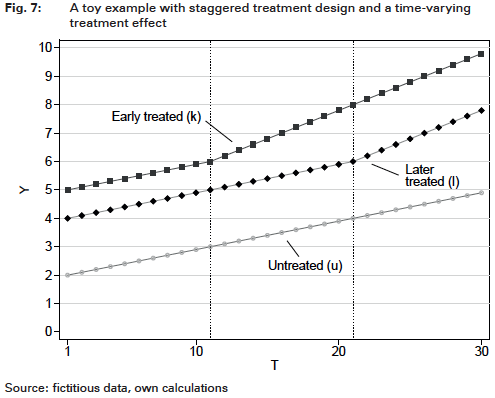
  • 陷阱5:交错干预事件的负向加权偏误(negative weighting bias with staggered treatment events)
    • 使用阶跃影响函数估计交错干预效应,存在负向加权偏差
    • 负向加权偏差发生的原因
      • 在接近窗口期结束时,较早接受干预的个体,成为了晚期接受干预个体的控制组
      • 固定效应模型对干预效应的估计将偏向早期干预效应
    • 案例:在完全平衡面板,U、K、L三组,U不接受干预,K在早期接受干预,L在晚期接受干预
    • 当平行趋势假设成立,标准双向固定效应估计量等同于DID估计量的加权之和(Goodman-Bacon 2018)
      • 因此,负向加权偏差既存在于固定效应估计,也存在于DID估计,还影响FEIS估计
    • 负向加权偏误
      • ψ_js是全样本的双向固定效应回归的残差
    • 由于时变干预效应的负向加权,必须在固定效应模型中纳入灵活的影响函数
      • 与名称相反,负向加权偏误往往使估计效应偏高
  • 陷阱6:反事实结果于估计样本的选择
    • 研究者通常试图最大化观测值,目的是保留一个具有代表性的样本,这种做法可能带来估计偏差的代价
    • 单数估计问题(singletons)
      • 面板数据观测值中只被观测一次的个案
      • 排除这类观测值,点估计不变,传统标准误不变
      • 单数估计会影响聚类稳健标准误
    • 纳入自始至终已接受干预的样本的问题
      • 如果观测值自窗口期已接受干预,将其保留会误将其归入对照组,从而造成效应估计偏差
      • 除非这类观测值存在明显时变干预效应,比如接受第二次干预
      • 一般而言,建议排除这类样本
    • 纳入从未接受干预的样本的问题
      • 为了控制年龄/时期效应,应该纳入从未接受干预的样本
  • 结论
    • 按照理论需求弹性设定影响函数
      • 大部分情况下应设定虚拟变量影响函数
      • 当出现规律性模式时,方可以转向其他简洁设定模式
    • 以灵活方式设定年龄结果轨迹(age- outcome trajectory)
      • 以年龄虚拟变量作为控制
      • 如果有必要,控制时期效应
      • 不要使用双向固定效应模型,主要是未经仔细考虑使用时期虚拟变量
    • 只有当理论说明有期望效应(anticipation effect)以及数据有直接测量时,才设定期望效应
      • 未经仔细考虑,勿加入干预前的虚拟变量(pre-treatment dummies)
      • 干预前虚拟变量容易使结果难以解释,并增加估计的不确定性
    • 不要按干预后的虚拟变量进行分组,并且最后缩短干预后时期
    • 不要最大化样本容量,相反应该根据研究问题量身定做估计样本。
      • 仅纳入第一次观测时没有被干预的单元(units not treated when first observed),排除一直获得干预的单元(unites always-treated)
      • 不要删除从来没有获得干预的单元(unites never-treated)
    • 对于连续发生的生命时间,建议在比较潜在结果基础上定义因果效应,重点关注具体的转变,并相应构建估计样本
    • 在建立影响函数模型时,考虑异质性生命历程(heterogeneous life courses),比如考虑个体指定斜率(individual-specific slopes)